 AI Tracker
Artificial Analysis i Arena plasują Kimi K3.1 Pro na 4. miejscu w swoich indeksach i na #8 w Code Arena WebDev
Dwaj niezależni ewaluatorzy opublikowali wyniki dla Kimi K3.1 Pro od Moonshot w ciągu godziny od premiery modelu. Obaj podają cenę 2 USD za milion tokenów wejściowych i 10 USD za milion tokenów wyjściowych; Artificial Analysis podaje cenę buforowanych danych wejściowych na poziomie 0,20 USD, o 33% niższą niż w przypadku Kimi K3.
Artificial Analysis podaje, że model uzyskał 55 punktów w Intelligence Index, o 11 więcej niż Kimi K3 (44), co daje mu 4. miejsce w klasyfikacji ogólnej — za Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) i Muse Wonder Full (56). Pozostałe wyniki:
- Zajmuje 3. miejsce w GDPval-AA z wynikiem 1 846 Elo, o 312 wyższym niż Kimi K3.
- Ma najwyższy wynik Terminal-Bench 4.0 spośród wszystkich testowanych modeli: 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- Wynik AutomationBench-AA wzrasta z 58% do 73%. Poprawa w Humanity's Last Exam (z 47% do 52%), CritPt (z 23% do 25%) i SciCode (z 59% do 61%) jest mniejsza.
- Wskaźnik halucynacji w AA-Omniscience spada z 53% do 44%.
- Koszt zadania wynosi około 1,98 USD, czyli mniej więcej tyle samo co w przypadku Kimi K3, ponieważ model wykorzystuje o 14% więcej tokenów wyjściowych.
- Po opublikowaniu wag byłby, według Artificial Analysis, modelem z otwartymi wagami o najwyższym wyniku, zmniejszającym różnicę względem modeli własnościowych z 12 do 3 punktów.
Arena podaje, że model zajmuje 8. miejsce w Code Arena: WebDev z wynikiem 1692 punktów — awansuje o 9 miejsc i zyskuje 37 punktów względem Kimi K3, dorównując Claude Opus 5 (Max) przy koszcie niższym, jak podaje Arena, o 70%. Mediana kosztu zadania wynosi 1,23 USD, o 29% mniej niż w przypadku Kimi K3. Arena podaje też 7. miejsce w Brand & Marketing i 9. miejsce w Simulations oraz twierdzi, że dzięki otwartym wagom model byłby najlepszym otwartym modelem w WebDev, przed DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (opublikowany później tego dnia): Kimi K3.1 Pro uzyskuje 64%, o 23 punkty więcej niż Kimi K3 (41%). Artificial Analysis twierdzi, że daje mu to pozycję najlepszego publicznie dostępnego modelu i drugą lokatę w klasyfikacji ogólnej — za GPT-6 Sol (Daybreak Blue, max) od OpenAI, dostępnym w ramach zaufanego dostępu, z wynikiem 69% — oraz przewagę nad DeepSeek V4.1 Flash 1017 (57%). Model uzyskał najwyższy wynik CyberGym-E2E-AA spośród wszystkich testowanych modeli (95%), 37% w DeepsecBench-AA i 61% w CWE-Bench-AA (prowadzi tam DeepSeek V4.1 Flash 1017 z wynikiem 69%); nie odmówił żadnego zadania ze względów bezpieczeństwa. Koszt zadania wynosi 2,81 USD, o 15% więcej niż w przypadku Kimi K3, ponieważ model wykorzystuje około dwa razy więcej tokenów wejściowych.
Extended NYT Connections (niezależny benchmark Lecha Mazura, opublikowany później tego dnia): Kimi K3.1 Pro (high) uzyskuje 93,4, nieznacznie ustępując Kimi K3 z wynikiem 93,6, przy mniejszej liczbie tokenów rozumowania. Mazur przetestował też GPT-6 Astra (max) i GPT-6.1 Sol (max); pierwsze miejsce nadal zajmuje Gemini 4 Argon (high).
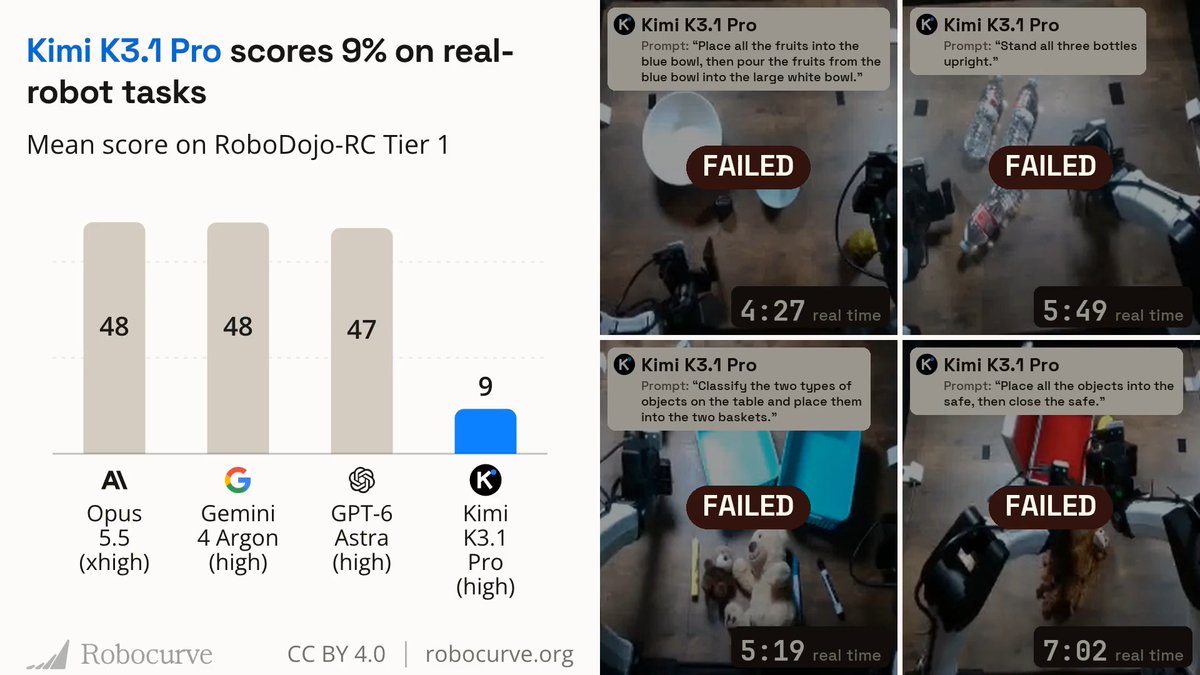
Zadania na prawdziwych robotach Robocurve (opublikowane tego wieczoru czasu pacyficznego): Robocurve, organizacja zajmująca się benchmarkami fizycznej AI, podaje, że Kimi K3.1 Pro uzyskał 9% w zadaniach na prawdziwych robotach, ustępując Claude Opus 5.5, Gemini 4 Argon i GPT-6 Astra.
Agent Arena (opublikowane 24 października przez Arena): Kimi K3.1 Pro (Max) debiutuje w Agent Arena na 11. miejscu, notując poprawę netto o 7,6% w ponad 4 000 rzeczywistych sesji agentowych użytkowników Arena. Arena twierdzi, że dzięki temu model byłby najlepszym otwartym modelem w Agent Arena, przed DeepSeek V4.1 Flash.
VulnPR-100 (opublikowane 24 października przez użytkownika przeprowadzającego benchmark BugBunny): po otrzymaniu 100 pull requestów z rozpoznanymi podatnościami i godziny na każdy PR, Kimi K3.1 Pro wykrył 47 podatności za 124,69 USD — o 10 więcej niż Kimi K3, przy koszcie niższym o 20,54 USD. W udostępnionym dalej poście dodano, że DeepSeek V4.1 Flash 1017 wykrył 54 podatności za 7,53 USD.
Mazebench (opublikowane 24 października przez autora benchmarku): Kimi K3.1 Pro uzyskuje 2%, co autor posta określa jako pierwszy niezerowy wynik modelu z otwartymi wagami; DeepSeek V4.1 Flash uzyskuje 1%.
Design Creativity Bench (opublikowane 24 października przez opiekuna benchmarku): ogólny wynik kreatywności Kimi K3.1 Pro wzrasta z 40,4 do 45,8 względem Kimi K3. Wynik adekwatności wzrasta z 96,8% do 98,5%, co według posta o benchmarku daje modelowi wynik wyższy niż wszystkim pozostałym ocenionym modelom z otwartymi wagami i równy wynikowi Claude Fable 5.1. Model generuje projekty niemal dwa razy szybciej niż Kimi K3, a mediana kosztu projektu spada o 18% — z 0,570 USD do 0,466 USD.
Tabela wyników DesignArena Website (opublikowana 24 października przez DesignArena): przewiduje się, że Kimi K3.1 Pro zajmie 1. miejsce wśród modeli z otwartymi wagami i ex aequo 3. miejsce w klasyfikacji ogólnej — za Muse Wonder (max) i Muse Spark 1.3 (xhigh), z wynikiem równym Muse Spark 1.3 Max. DesignArena podaje, że model wyprzedza Kimi K3 o 15 punktów Elo w rankingu modeli z otwartymi wagami.
LLM Creative Story-Writing Benchmark (opublikowane 24 października przez Lecha Mazura): Kimi K3.1 Pro (high) uzyskuje 2,72, w porównaniu z 2,35 dla Kimi K3. W teście 50 dopasowanych promptów model odnosi 35 zwycięstw, notuje 8 remisów i ponosi 7 porażek z Kimi K3. Mazur twierdzi, że główna poprawa dotyczy lepszego prowadzenia fabuły: wymagane elementy konsekwentniej kształtują decyzje postaci i ich konsekwencje. Dodaje też, że model wykorzystuje o 34% mniej tokenów rozumowania.
Źródła
- Wielka wiadomość: @Kimi_Moonshot wraca do grona 4 najlepszych laboratoriów w Code Arena: WebDev dzięki premierze Kimi K3.1 Pro!X · 3 komentarze
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 komentarzy
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 komentarz
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 komentarzy
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 komentarze
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 komentarz
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 komentarzy
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 komentarzy
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 komentarze
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 komentarzy
Dyskusje
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 komentarze
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 komentarzy
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 komentarzy
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 komentarzy
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 komentarzy
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 komentarze
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 komentarze
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 komentarze
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 komentarzy
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 komentarzy
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 komentarzy
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.