AI Tracker
News zu Modelle,
für Entwickler.
Die neuesten News zu Modelle von allen AI-Anbietern: Launches, Preisänderungen und Abkündigungen, zusammengefasst mit dem, was sie für dich bedeuten.
PokeBot startet RoboAPI: Eine API, mit der Roboterarme natürlichsprachliche Anweisungen ausführen
PokeBot hat am 29. Oktober RoboAPI vorgestellt. Der Dienst basiert auf Poke-Aurora, das Unternehmen als sein Weltaktionsmodell bezeichnet. Laut PokeBot können kompatible Roboter über eine einfache API natürlichsprachliche Anweisungen entgegennehmen – ohne aufgabenspezifisches Training.Pika bringt H3 Flex auf den Markt, ein schnelles Videomodell, das laut Unternehmen das führende Open-Weight-Text-zu-Video-Modell auf DesignArena ist
Pika hat H3 Flex vorgestellt. Laut dem Unternehmen debütiert das Modell als Nr. 1 auf DesignArenas Text-zu-Video-Rangliste für Open-Weight-Modelle (eine Behauptung von Pika). Das Modell sei für professionelle Iterationen entwickelt worden und biete exportierbare Audiospuren, Auflösungen von bis zu 4K und eine Generierung schneller als in Echtzeit. Ein 15-sekündiger Clip samt Soundtrack lasse sich in nur 7 Sekunden erstellen.OpenAI aktualisiert seine Model Spec anhand von fünf Kernwerten
OpenAI hat eine aktualisierte Model Spec veröffentlicht, die öffentliche Beschreibung dessen, wie sich seine Modelle verhalten sollen. Die Überarbeitung ordnet die Leitlinien anhand von fünf Werten neu: Treue zu menschlichen Absichten, Schadensminimierung, Ehrlichkeit und Transparenz, menschliche Handlungsfähigkeit und Fürsorge. Alles Folgende ist OpenAIs Darstellung.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 startet auf Platz 1 im Speech to Speech Index von Artificial Analysis
Artificial Analysis (eine Benchmark-Website mit eigenen Messungen) zufolge belegt Phonic 1 (High), das Speech-to-Speech-Modell von Phonic, mit 87,1 Punkten Platz 1 von 22 im Speech to Speech Index und liegt damit knapp vor Grok Voice 3.0 (86,9). Das Modell ist über die Phonic API für 0,07 $ pro Minute verfügbar.Fish Audio veröffentlicht Drama 3, das laut Artificial Analysis unter den Open-Weight-Sprachmodellen auf Platz 1 liegt
Fish Audio hat Drama 3 veröffentlicht; die Gewichte sind auf Hugging Face verfügbar. Artificial Analysis (eine Benchmark-Website, eigene Messungen) gibt an, dass das Modell in beiden Speech Arenas die Nummer 1 unter den Open-Weight-Modellen ist und im Benchmark Pronunciation Robustness unter allen Modellen auf Platz 1 liegt.Mistral veröffentlicht die Gewichte von Mistral Large 4, einem Modell mit 1 Billion Parametern, zum etwa halben Preis der Preview
Mistral hat die Gewichte einer verbesserten Version von Mistral Large 4 ("Le Chonk") veröffentlicht, seinem multimodalen Flaggschiffmodell mit 1 Billion Parametern, das Anfang des Monats in die öffentliche Preview gestartet ist. Die Gewichte sind auf Hugging Face als Mistral-Large-4-1T-A52B sowie in einer NVFP4-Version verfügbar. Mistral bezeichnet das Modell als in Europa trainiert und als bestes Modell mit offenen Gewichten für Coding. Ein Kommentator merkt an, dass es sich um eine modifizierte MIT-Lizenz handelt, die nicht von der OSI anerkannt ist.Qwen 4 ist noch nicht angekündigt, aber Qwen Code führt bereits Qwen4-Modell-IDs auf
Ein X-Account berichtet, dass Qwen Code v0.26.3, veröffentlicht am 28. Oktober, eine Änderung enthält (Pull Request #15762 im offiziellen Repository QwenLM/qwen-code), durch die jedes Modell, dessen ID mit qwen4 beginnt, standardmäßig einen Kontext von 1 Mio. Tokens erhält. Laut diesem Account nennen die Tests qwen4-max, qwen4-plus, qwen4-coder-plus, das datierte qwen4-max-2026-10-01 und qwen4.5-max. Der Beitrag des Accounts verlinkt den Pull Request und zeigt einen Screenshot.Artificial Analysis zeigt AA-Robotics v0.1, einen Benchmark für Modelle, die einen Roboterarm steuern
Artificial Analysis hat AA-Robotics v0.1 veröffentlicht. Der Benchmark lässt Modelle einen Roboterarm steuern und zeigt die Aufgabe aus der Sicht des Modells. In einem Beispiel, in dem derselbe Roboter „hello world“ schreibt, zufolge Artificial Analysis tupfte Claude Opus 5.5 die Buchstaben Punkt für Punkt auf – mit 3.270 Armbewegungen in 34 Minuten –, während GPT-6 Astra in durchgehenden Strichen schrieb – mit 514 Bewegungen in 13 Minuten.Particle-1, ein auf DeepSeek V4.1 Flash nachtrainiertes Modell, ist jetzt auf Vercel AI Gateway verfügbar
Vercel zufolge ist Particle-1 (particle/particle-1) jetzt auf AI Gateway verfügbar, dem einheitlichen Endpunkt für Modellanbieter. Vercel sagt, das Modell sei auf DeepSeek V4.1 Flash nachtrainiert worden und erledige technische Aufgaben mit weniger Tokens. Empfohlen wird es für Debugging, die Planung von Codeänderungen und die Aufteilung mehrstufiger Probleme.Artificial Analysis veröffentlicht AA-PersonalityBench: GPT-6- und Grok-Modelle sind am direktesten
Artificial Analysis hat AA-PersonalityBench veröffentlicht, einen Benchmark für Persönlichkeitsmerkmale von Modellen. Dazu gibt es eine Ergebnisseite, eine Methodikseite und ein Tool, mit dem sich ein eigenes Persönlichkeitsranking erstellen lässt. Die Bewertungen stammen von der Website selbst.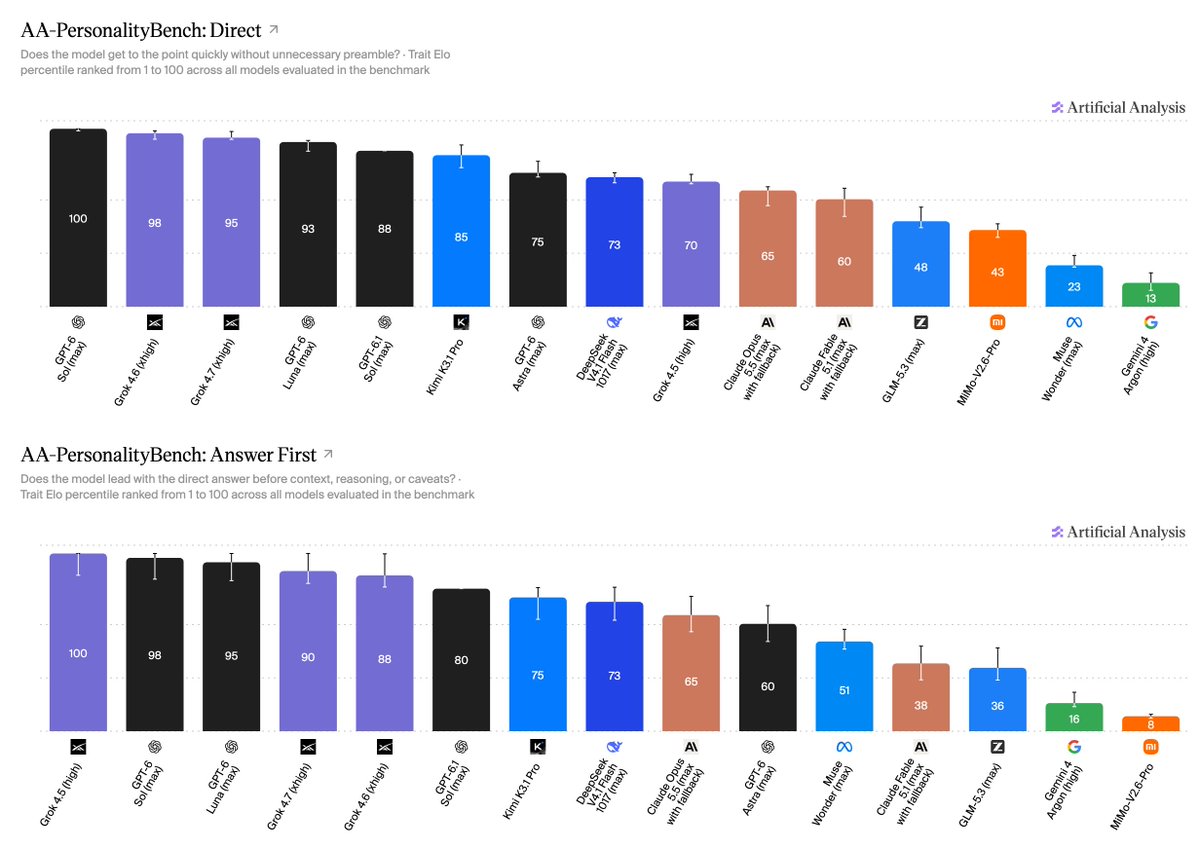
ElevenLabs stellt Cue vor, ein Forced-Alignment-Modell
ElevenLabs Research hat Cue vorgestellt, ein Forced-Alignment-Modell: der Schritt, der ein Transkript mit Zeitstempeln versieht – für Untertitel, Synchronisation und anklickbare Transkripte. Cue ordnet jedes Zeichen der Audio-Zeitachse zu.Rime bringt Prism auf den Markt, ein Speech-to-Speech-Modell für Sprachagenten
Rime hat Prism vorgestellt, ein Speech-to-Speech-Modell für KI-Sprachagenten. Die folgenden Angaben stammen von Rime selbst und wurden nicht unabhängig überprüft.Artificial Analysis startet AA-Video-I2V v2.1, einen Benchmark für Image-to-Video-Modelle
Artificial Analysis hat AA-Video-I2V v2.1 und AA-Video-I2V-Silent v2.1 gestartet, einen Benchmark für Image-to-Video-Modelle. Jeder Prompt kombiniert ein 1080p-Startbild mit einem dafür verfassten Prompt und ist nach Anwendungsfall, Fähigkeit und visuellem Stil kategorisiert; die Modelle werden mit bis zu 1080p bewertet und über 10 Anwendungsfälle und 10 Fähigkeiten hinweg eingestuft. Für die Gesamtrangliste werden alle Bereiche gleichmäßig berücksichtigt. Die Ergebnisse stammen von Artificial Analysis selbst.
GitHub Copilot Fusion, das für jede Aufgabe Modelle auswählt und orchestriert, ist allgemein verfügbar
GitHub gibt bekannt, dass Copilot Fusion allgemein verfügbar ist. Statt ein Modell auszuwählen, wählt man im Modellauswahlmenü Copilot Fusion und eine Aufwandsstufe (Standard, High oder Max); Copilot entscheidet, welche Modelle zum Einsatz kommen und wie sie zusammenarbeiten. Fusion kombiniert die Multi-Modell-Orchestrierung der früheren Vorschau von Project HydraFusion mit der automatischen Modellauswahl von Copilot. Zu den Workflows gehören ein einzelnes Modell, eine Kaskade (ein effizientes Modell erstellt einen Entwurf, und eine Qualitätsprüfung entscheidet, ob eine Eskalation nötig ist) sowie eine Kritik (ein Modell erstellt einen Entwurf, ein anderes prüft ihn, und das erste überarbeitet ihn).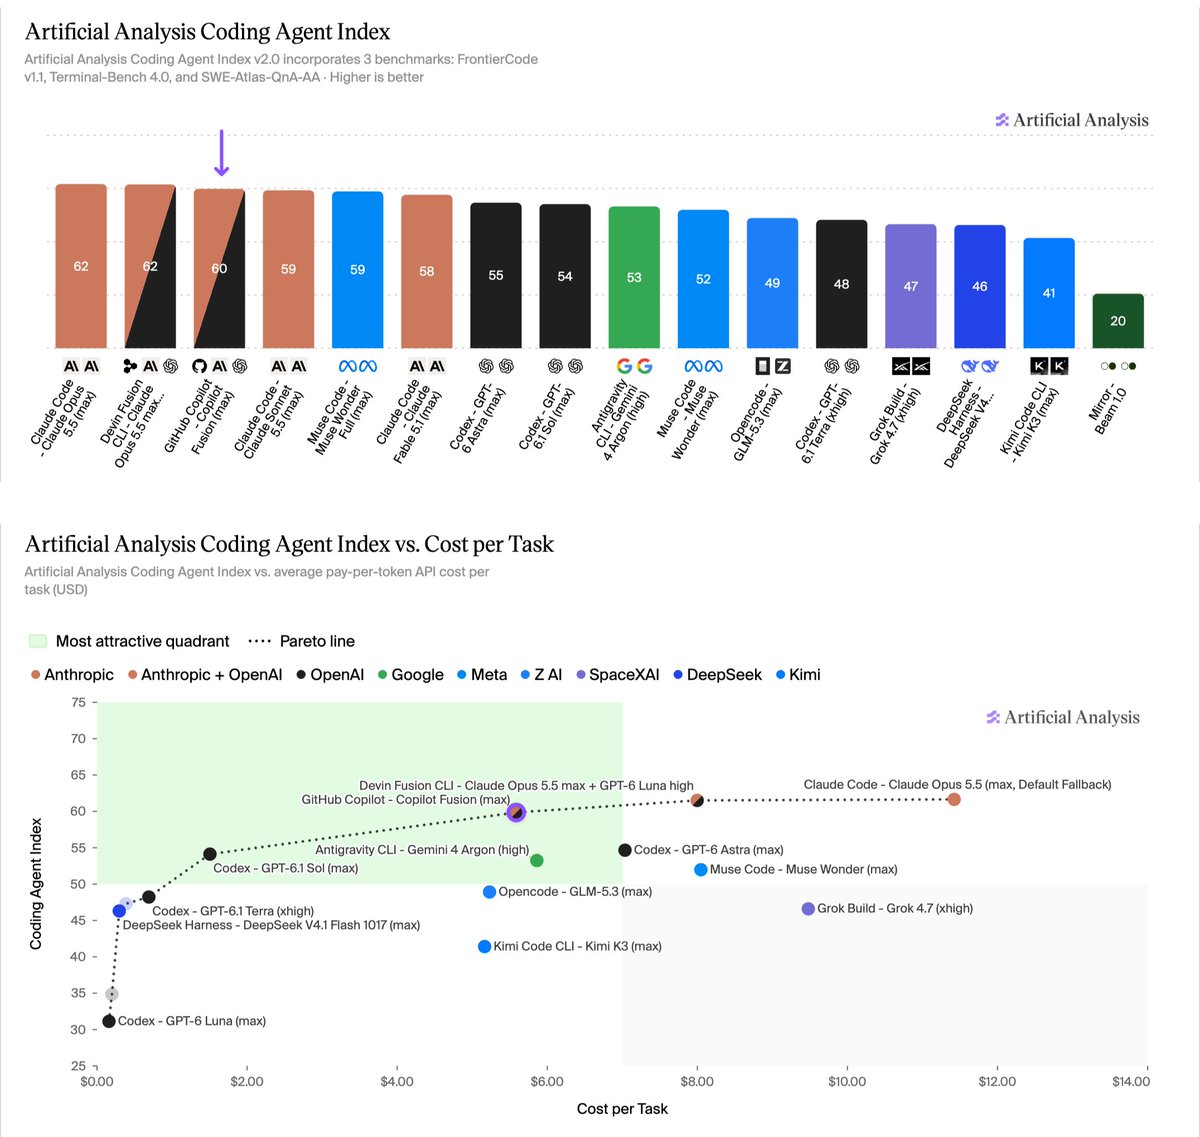
OpenBMB veröffentlicht MiniCPM-OCR, einen Dokumentenparser mit 1B Parametern, sowie ein 2B-Modell zur Bewertung von OCR-Ergebnissen
OpenBMB zeigte MiniCPM-OCR am 28. Oktober auf X im lokalen Betrieb auf einem iPhone und einem iPad. Das Modell wird mit offenen Gewichten veröffentlicht und kann mit llama.cpp, vLLM, SGLang oder Ollama ausgeführt werden. Der Fine-Tuning-Code ist Open Source; außerdem bietet OpenBMB eine Demo und eine API an.AssemblyAI bringt sein erstes Text-to-Speech-Modell auf den Markt: AssemblyAI-TTS-1
AssemblyAI hat AssemblyAI-TTS-1 eingeführt, sein erstes Text-to-Speech-Modell, das für Sprachagenten entwickelt wurde. AssemblyAI zufolge streamt es mit einer Latenz von 90 ms und kostet 15 $ pro einer Million Zeichen. Das Unternehmen bezeichnet es als das beste TTS-Modell, das sich in großem Maßstab einsetzen lässt und Genauigkeit, Natürlichkeit und Kosten vereint. OpenRouter zufolge ist das Modell dort verfügbar; über 4.000 Stimmen werden aus den USA oder der EU bereitgestellt.
NVIDIA veröffentlicht Nemotron 3.5 Transcribe mit offenen Gewichten, das bei Artificial Analysis gemeinsam auf Platz 1 unter den Speech-to-Text-Modellen mit offenen Gewichten liegt
NVIDIA Nemotron 3.5 Transcribe ist ein neues, promptfähiges Speech-to-Text-Modell mit offenen Gewichten: ein Mixture-of-Experts-Modell mit 30B Parametern, von denen etwa 4B aktiv sind. NVIDIA zufolge deckt ein einzelner Checkpoint die Transkription in 40 Sprachen, Sprecherzuordnung, Übersetzung, kontextbezogenes Prompting und Audioverständnis ab. Gewichte, Daten und Rezepte seien offen. Das Modell ist auf Hugging Face verfügbar, außerdem gibt es eine Live-Demo.Mistral stellt eine Responses API als Public Preview bereit und hostet DeepSeek V4.1 Flash und GLM 5.3 Flash
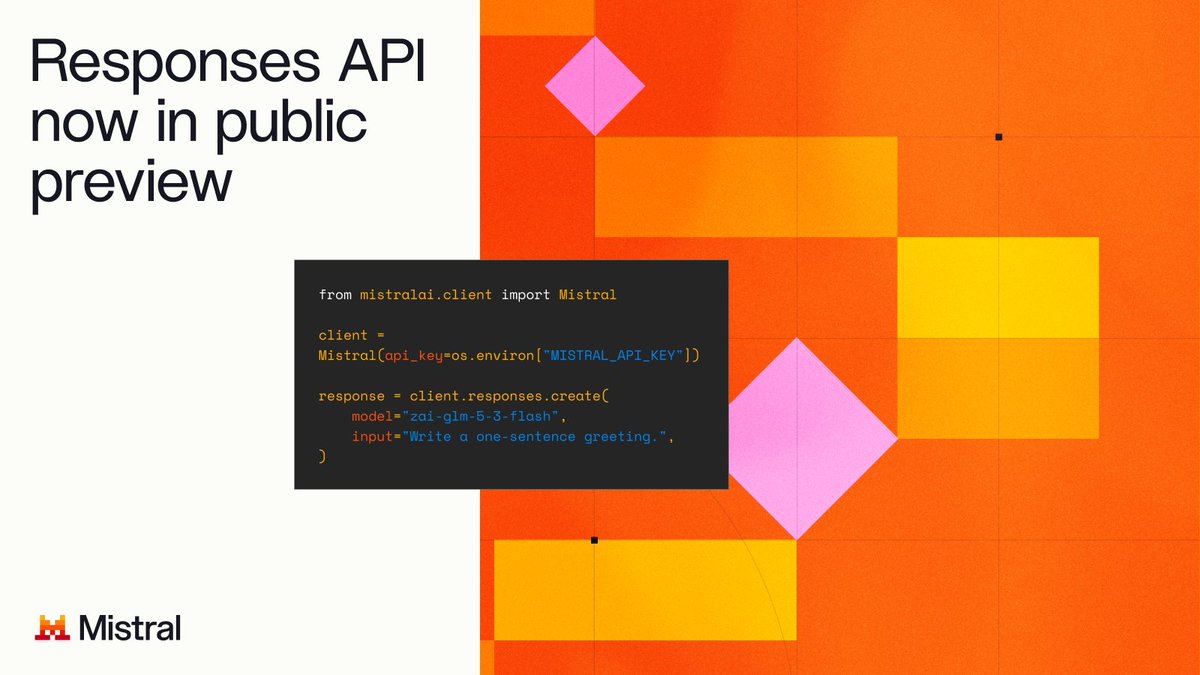
Mistral gab am 28. Oktober bekannt, dass seine Responses API, die für die Entwicklung von Agents auf Mistral konzipiert ist, als Public Preview verfügbar ist. Laut Mistral gibt jede Antwort die Modellantwort, die Überlegungen des Modells und seine Tool-Aufrufe als separate Elemente zurück. So kann eine App jeden Schritt leichter verarbeiten als mit Chat Completions. Die API funktioniert mit allen von Mistral gehosteten Chat-Modellen, einschließlich Large 4. Die Dokumentation ist auf der Dokumentationsseite von Mistral Studio verfügbar.