AI Tracker
Modelli: le notizie,
per chi sviluppa.
Le ultime notizie su modelli da ogni provider AI: lanci, cambi di prezzo e dismissioni, riassunti con cosa significano per te.
PokeBot lancia RoboAPI, un’API che consente di impartire istruzioni in linguaggio naturale ai bracci robotici
PokeBot ha presentato RoboAPI il 29 ottobre. Il servizio è basato su Poke-Aurora, che l’azienda definisce il suo modello per le azioni nel mondo reale. Secondo PokeBot, i robot compatibili possono ricevere istruzioni in linguaggio naturale tramite una semplice API, senza bisogno di addestramento specifico per ogni attività.Pika lancia H3 Flex, un modello video veloce che definisce il miglior modello open-weight text-to-video su DesignArena
Pika ha presentato H3 Flex, che secondo l’azienda debutta al primo posto tra i modelli open-weight nella classifica text-to-video di DesignArena (affermazione di Pika). Descrive il modello come pensato per l’iterazione professionale: tracce audio esportabili, risoluzioni fino a 4K e generazione più veloce del tempo reale, con una clip di 15 secondi e colonna sonora create in appena 7 secondi.OpenAI aggiorna il suo Model Spec attorno a cinque valori fondamentali
OpenAI ha pubblicato una versione aggiornata del Model Spec, la descrizione pubblica di come vuole che si comportino i suoi modelli. La revisione riorganizza le linee guida attorno a cinque valori: fedeltà alle intenzioni umane, riduzione dei danni, onestà e trasparenza, autonomia umana e attenzione. Tutto ciò che segue è quanto riferisce OpenAI.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 debutta al primo posto nello Speech to Speech Index di Artificial Analysis
Artificial Analysis (un sito di benchmark, con misurazioni proprie) afferma che Phonic 1 (High), il modello speech-to-speech di Phonic, si colloca al primo posto su 22 nello Speech to Speech Index, con 87,1 punti, di poco davanti a Grok Voice 3.0 (86,9). Il modello è disponibile tramite l'API di Phonic a $0,07 al minuto.Fish Audio lancia Drama 3, che Artificial Analysis classifica al primo posto tra i modelli vocali open-weight
Fish Audio ha rilasciato Drama 3, con i pesi disponibili su Hugging Face. Artificial Analysis (un sito di benchmark, secondo le proprie misurazioni) afferma che è il modello open-weight al primo posto in entrambe le sue Speech Arena e al primo posto tra tutti i modelli nel benchmark Pronunciation Robustness.Mistral rilascia i pesi di Mistral Large 4, un modello da 1.000 miliardi di parametri, a circa metà del prezzo dell’anteprima
Mistral ha pubblicato i pesi di una versione migliorata di Mistral Large 4 ("Le Chonk"), il suo modello multimodale nativo di punta da 1.000 miliardi di parametri, entrato in anteprima pubblica all’inizio del mese. I pesi sono disponibili su Hugging Face come Mistral-Large-4-1T-A52B e in una versione NVFP4. Mistral lo definisce addestrato in Europa e il miglior modello a pesi aperti per la programmazione. Un commentatore afferma che la licenza è una MIT modificata, non approvata dall’OSI.Qwen 4 non è stato annunciato, ma Qwen Code elenca già gli ID dei modelli Qwen4
Un account su X riferisce che Qwen Code v0.26.3, rilasciato il 28 ottobre, include una modifica (pull request #15762 nel repository ufficiale QwenLM/qwen-code) che assegna per impostazione predefinita una finestra di contesto da 1M token a ogni modello il cui ID inizia con qwen4. Secondo l'account, i test citano qwen4-max, qwen4-plus, qwen4-coder-plus, qwen4-max-2026-10-01 con data e qwen4.5-max. Il post dell'account rimanda alla pull request e mostra uno screenshot.Artificial Analysis presenta AA-Robotics v0.1, un benchmark di modelli che controllano un braccio robotico
Artificial Analysis ha pubblicato AA-Robotics v0.1, che mette i modelli alla guida di un braccio robotico e mostra l’attività dal punto di vista del modello. In un esempio in cui lo stesso robot scrive «hello world», Artificial Analysis afferma che Claude Opus 5.5 l’ha scarabocchiato punto per punto, con 3.270 movimenti del braccio in 34 minuti, mentre GPT-6 Astra ha scritto con tratti continui, con 514 movimenti in 13 minuti.Particle-1, un modello sottoposto a post-training su DeepSeek V4.1 Flash, è ora disponibile su Vercel AI Gateway
Vercel afferma che Particle-1 (particle/particle-1) è ora disponibile su AI Gateway, il suo endpoint unificato per i provider di modelli. Secondo Vercel, il modello è stato sottoposto a post-training su DeepSeek V4.1 Flash e completa attività di ingegneria con meno token; Vercel lo consiglia per il debugging, la pianificazione di modifiche al codice e la scomposizione di problemi in più fasi.Artificial Analysis pubblica AA-PersonalityBench: i modelli GPT-6 e Grok sono i più diretti
Artificial Analysis ha pubblicato AA-PersonalityBench, un benchmark dei tratti della personalità dei modelli, con una pagina dei risultati, una pagina sulla metodologia e uno strumento per creare la propria classifica della personalità. I punteggi sono elaborati dal sito stesso.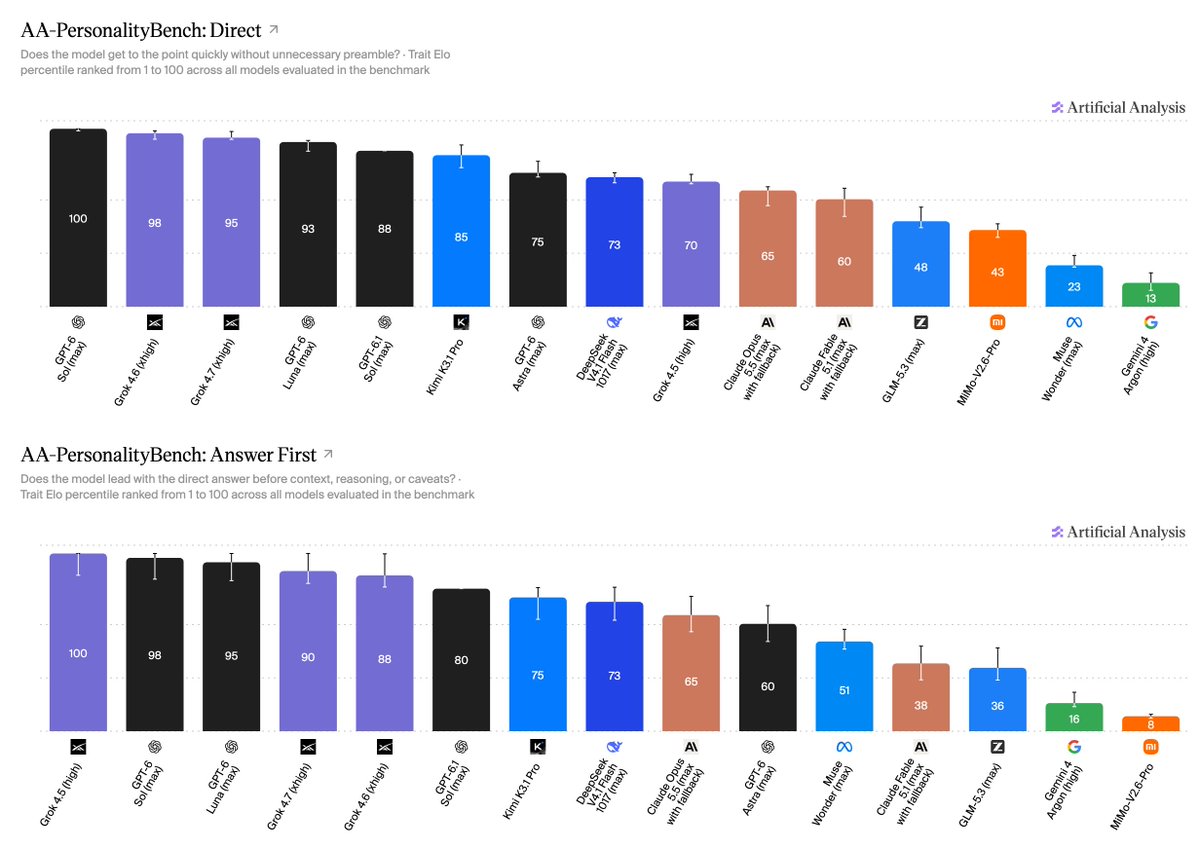
ElevenLabs presenta Cue, un modello di allineamento forzato
ElevenLabs Research ha presentato Cue, un modello di allineamento forzato: il passaggio che trasforma una trascrizione in marcature temporali, usate per sottotitoli, doppiaggio e trascrizioni interattive. Cue colloca ogni carattere sulla linea temporale dell’audio.Rime lancia Prism, un modello speech-to-speech per agenti vocali
Rime ha lanciato Prism, un modello speech-to-speech per agenti vocali basati sull’IA. I dati riportati di seguito sono dichiarazioni di Rime, non misurazioni indipendenti.Artificial Analysis lancia AA-Video-I2V v2.1, un benchmark per i modelli di generazione video da immagini
Artificial Analysis ha lanciato AA-Video-I2V v2.1 e AA-Video-I2V-Silent v2.1, un benchmark per i modelli di generazione video da immagini. Ogni prompt abbina un'immagine iniziale a 1080p a un prompt scritto appositamente per essa ed è classificato per caso d'uso, capacità e stile visivo; i modelli vengono valutati fino a 1080p e classificati in 10 casi d'uso e 10 capacità. La classifica generale assegna lo stesso peso a ciascuna categoria. I risultati sono elaborati da Artificial Analysis.
GitHub Copilot Fusion, che instrada e orchestra i modelli per ogni attività, è disponibile a tutti
GitHub annuncia la disponibilità generale di Copilot Fusion. Invece di scegliere un modello, l’utente seleziona Copilot Fusion nel selettore dei modelli e un livello di impegno (Standard, High o Max); Copilot decide quali modelli usare e come combinarli. Unisce l’orchestrazione multi-modello dell’anteprima precedente Project HydraFusion alla selezione automatica dei modelli di Copilot. I flussi di lavoro includono un singolo modello, una cascata (un modello efficiente prepara una bozza e un controllo qualità decide se passare a un modello superiore) e una revisione critica (un modello prepara una bozza, un altro la esamina e il primo la rivede).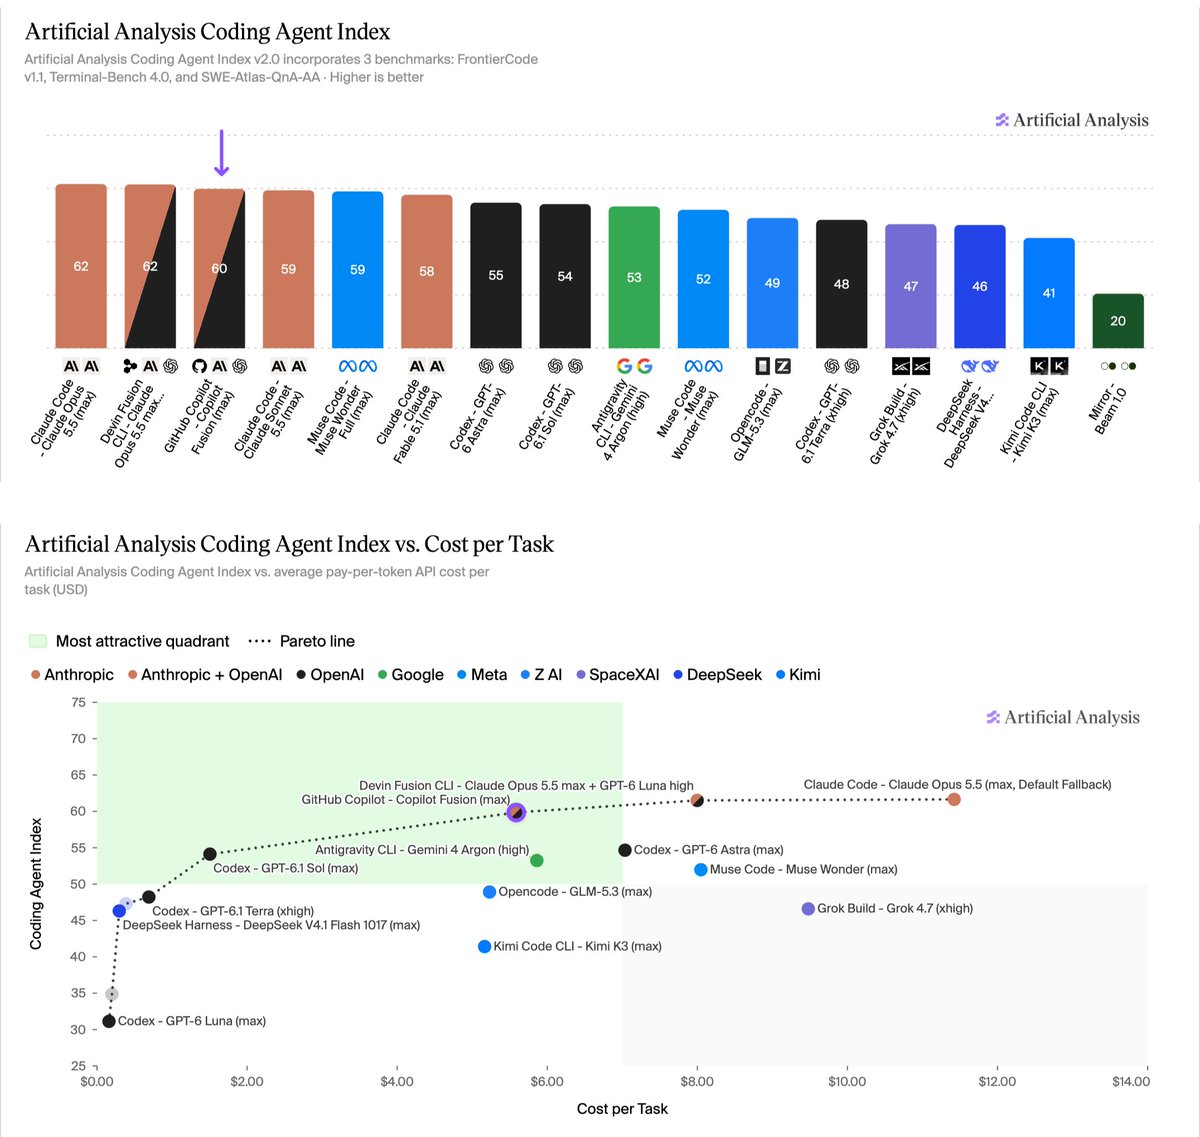
OpenBMB lancia MiniCPM-OCR, un parser di documenti da 1B, con un modello da 2B che assegna punteggi ai risultati OCR
OpenBMB ha mostrato MiniCPM-OCR su X il 28 ottobre, in esecuzione in locale su un iPhone e un iPad. È rilasciato con pesi aperti e può essere eseguito con llama.cpp, vLLM, SGLang o Ollama; il codice per il fine-tuning è open source e OpenBMB offre anche una demo e un'API.AssemblyAI lancia il suo primo modello di sintesi vocale, AssemblyAI-TTS-1
AssemblyAI ha lanciato AssemblyAI-TTS-1, il suo primo modello di sintesi vocale, progettato per agenti vocali. AssemblyAI afferma che il modello trasmette l'audio in streaming in 90 ms al costo di 15 $ per milione di caratteri e lo definisce il miglior modello TTS eseguibile su larga scala considerando insieme precisione, naturalezza e costo. OpenRouter afferma che il modello è disponibile sulla piattaforma, con oltre 4.000 voci servite dagli Stati Uniti o dall'UE.
NVIDIA lancia Nemotron 3.5 Transcribe open-weight, a pari merito al primo posto tra i modelli speech-to-text open-weight secondo Artificial Analysis
Nemotron 3.5 Transcribe di NVIDIA è un nuovo modello speech-to-text open-weight e programmabile tramite prompt: un modello mixture-of-experts da 30B, con circa 4B di parametri attivi. NVIDIA afferma che un unico checkpoint gestisce la trascrizione in 40 lingue, l’attribuzione degli speaker, la traduzione, il prompting contestuale e la comprensione dell’audio, e che pesi, dati e procedure sono aperti. È disponibile su Hugging Face, con una demo interattiva.Mistral apre in anteprima pubblica una Responses API e rende disponibili DeepSeek V4.1 Flash e GLM 5.3 Flash
Il 28 ottobre Mistral ha annunciato che la sua Responses API, pensata per creare agenti su Mistral, è in anteprima pubblica. Secondo Mistral, ogni risposta restituisce come elementi separati la risposta del modello, il suo ragionamento e le chiamate agli strumenti, così un'app può gestire ogni passaggio più facilmente rispetto a Chat Completions. Funziona con tutti i modelli chat ospitati da Mistral, incluso Large 4. La documentazione è disponibile sul sito della documentazione di Mistral Studio.