AI Tracker
Modele: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Modele” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
PokeBot uruchamia RoboAPI — API, które pozwala wydawać ramionom robotycznym polecenia w języku naturalnym
29 października PokeBot zaprezentował RoboAPI, oparte na Poke-Aurora, które firma określa mianem swojego modelu działań w świecie rzeczywistym. Według firmy zgodne roboty mogą przyjmować polecenia w języku naturalnym za pośrednictwem prostego API, bez trenowania pod kątem konkretnych zadań.Pika wprowadza H3 Flex — szybki model wideo, który według firmy jest najlepszym otwartym modelem text-to-video w DesignArena
Pika wprowadziła H3 Flex, który — jak twierdzi firma — debiutuje na 1. miejscu w rankingu modeli open-weight do generowania wideo z tekstu w DesignArena (twierdzenie Pika). Model ma być przeznaczony do profesjonalnej pracy iteracyjnej: oferuje możliwość eksportowania osobnych ścieżek audio, rozdzielczość do 4K i generowanie szybsze niż w czasie rzeczywistym; klip o długości 15 sekund wraz ze ścieżką dźwiękową może powstać zaledwie w 7 sekund.OpenAI aktualizuje Model Spec, opierając go na pięciu podstawowych wartościach
OpenAI opublikowało zaktualizowany Model Spec, publiczny opis tego, jak chce, by zachowywały się jego modele. W tej wersji wytyczne uporządkowano wokół pięciu wartości: wierności ludzkim intencjom, minimalizowania szkód, uczciwości i przejrzystości, ludzkiej sprawczości oraz troski. Wszystkie poniższe informacje pochodzą od OpenAI.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 debiutuje na 1. miejscu w Speech to Speech Index serwisu Artificial Analysis
Artificial Analysis (serwis benchmarkowy, własne pomiary) podaje, że Phonic 1 (High), model speech-to-speech firmy Phonic, zajmuje 1. miejsce na 22 modele w jego Speech to Speech Index z wynikiem 87,1, nieznacznie wyprzedzając Grok Voice 3.0 (86,9). Model jest dostępny przez Phonic API w cenie 0,07 USD za minutę.Fish Audio wypuszcza Drama 3, który Artificial Analysis plasuje na 1. miejscu wśród modeli mowy z otwartymi wagami
Fish Audio wypuściło Drama 3, którego wagi są dostępne na Hugging Face. Artificial Analysis (serwis benchmarkowy, bazujący na własnych pomiarach) podaje, że to model z otwartymi wagami zajmujący 1. miejsce na obu ich arenach modeli mowy oraz 1. miejsce wśród wszystkich modeli w benchmarku Pronunciation Robustness.Mistral udostępnia wagi Mistral Large 4, modelu z 1 bilionem parametrów, za cenę około połowy ceny wersji preview
Mistral opublikował wagi ulepszonego modelu Mistral Large 4 ("Le Chonk"), swojego flagowego, natywnie multimodalnego modelu z 1 bilionem parametrów, który trafił do publicznego preview na początku tego miesiąca. Wagi są dostępne w Hugging Face jako Mistral-Large-4-1T-A52B oraz w wersji NVFP4. Mistral określa model jako wytrenowany w Europie i najlepszy model z otwartymi wagami do kodowania. Jeden z komentujących twierdzi, że licencja to zmodyfikowana MIT, a nie licencja zatwierdzona przez OSI.Qwen 4 nie został zapowiedziany, ale Qwen Code już wymienia identyfikatory modeli qwen4
Konto na X podaje, że Qwen Code v0.26.3, wydany 28 października, zawiera zmianę (pull request #15762 w oficjalnym repozytorium QwenLM/qwen-code), która domyślnie przypisuje kontekst o długości 1M tokenów każdemu modelowi, którego identyfikator zaczyna się od qwen4. Według tego konta w testach wymieniono qwen4-max, qwen4-plus, qwen4-coder-plus, model z datą qwen4-max-2026-10-01 oraz qwen4.5-max. W poście zamieszczono link do pull requesta i zrzut ekranu.Artificial Analysis prezentuje AA-Robotics v0.1 — benchmark modeli sterujących ramieniem robota
Artificial Analysis opublikowało AA-Robotics v0.1, benchmark, w którym modele sterują ramieniem robota, a zadanie pokazane jest z perspektywy modelu. W przykładzie, w którym ten sam robot pisze „hello world”, Artificial Analysis podaje, że Claude Opus 5.5 wypisał tekst, stawiając kropkę po kropce, wykonując 3 270 ruchów ramieniem w ciągu 34 minut, podczas gdy GPT-6 Astra napisał go ciągłymi pociągnięciami, wykonując 514 ruchów w 13 minut.Particle-1, model dostrojony po treningu na DeepSeek V4.1 Flash, jest już dostępny w Vercel AI Gateway
Vercel informuje, że Particle-1 (particle/particle-1) jest już dostępny w AI Gateway, ujednoliconym punkcie dostępu do modeli różnych dostawców. Według Vercel model został dostrojony po treningu na DeepSeek V4.1 Flash i wykonuje zadania inżynieryjne przy użyciu mniejszej liczby tokenów. Vercel poleca go do debugowania, planowania zmian w kodzie i rozbijania wieloetapowych problemów na mniejsze części.Artificial Analysis publikuje AA-PersonalityBench: modele GPT-6 i Grok są najbardziej bezpośrednie
Artificial Analysis opublikowało AA-PersonalityBench — benchmark cech osobowości modeli — wraz ze stroną wyników, stroną opisującą metodologię i narzędziem do tworzenia własnego rankingu osobowości. Wyniki pochodzą od samej witryny.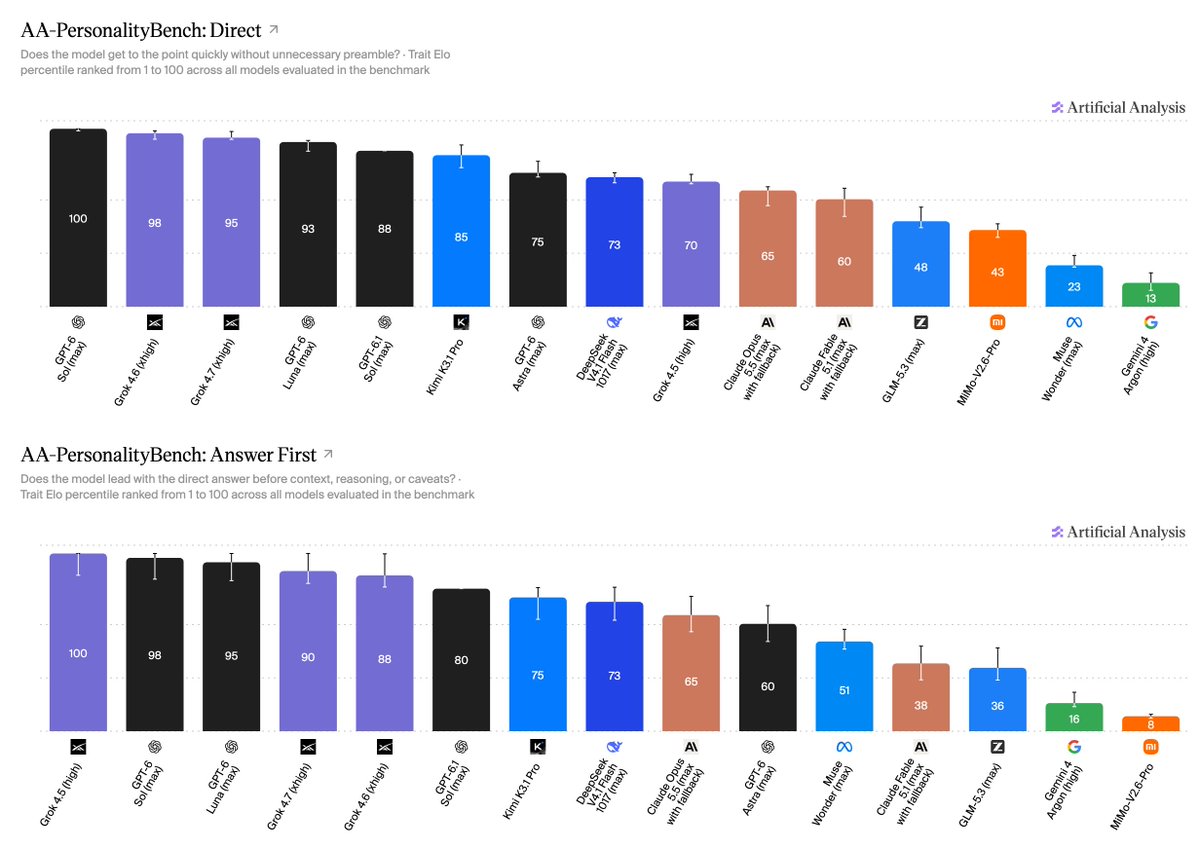
ElevenLabs przedstawia Cue, model do wymuszonego wyrównywania
Zespół badawczy ElevenLabs przedstawił Cue, model do wymuszonego wyrównywania — etap, który przekształca transkrypcję w znaczniki czasu wykorzystywane w napisach, dubbingu i transkrypcjach z klikalnymi fragmentami. Przypisuje każdy znak do osi czasu nagrania.Rime wprowadza Prism, model speech-to-speech dla agentów głosowych
Rime wprowadziło Prism, model speech-to-speech dla głosowych agentów AI. Poniższe dane to deklaracje Rime, a nie wyniki niezależnych pomiarów.Artificial Analysis uruchamia AA-Video-I2V v2.1, benchmark modeli image-to-video
Artificial Analysis uruchomiła AA-Video-I2V v2.1 i AA-Video-I2V-Silent v2.1 — benchmark modeli image-to-video. Każdy prompt łączy obraz początkowy w rozdzielczości 1080p z przygotowanym dla niego promptem i jest oznaczony kategorią zastosowania, możliwości oraz stylu wizualnego; modele są oceniane w rozdzielczości do 1080p i klasyfikowane w 10 kategoriach zastosowań oraz 10 kategoriach możliwości. W rankingu ogólnym próbki są równomiernie dobierane z tych kategorii. Wyniki pochodzą od Artificial Analysis.
GitHub Copilot Fusion, który dobiera modele do poszczególnych zadań i koordynuje ich pracę, jest już ogólnie dostępny
GitHub ogłasza ogólną dostępność Copilot Fusion. Zamiast wybierać model, użytkownik wybiera Copilot Fusion w selektorze modeli oraz poziom intensywności (Standard, High lub Max); Copilot decyduje, których modeli użyć i jak mają współpracować. Rozwiązanie łączy koordynację wielu modeli z wcześniejszej wersji zapoznawczej Project HydraFusion z automatycznym doborem modelu w Copilot. Dostępne tryby pracy to pojedynczy model, kaskada (wydajny model tworzy projekt, a kontrola jakości decyduje, czy przekazać zadanie dalej) oraz krytyka (jeden model tworzy projekt, drugi go ocenia, a pierwszy wprowadza poprawki).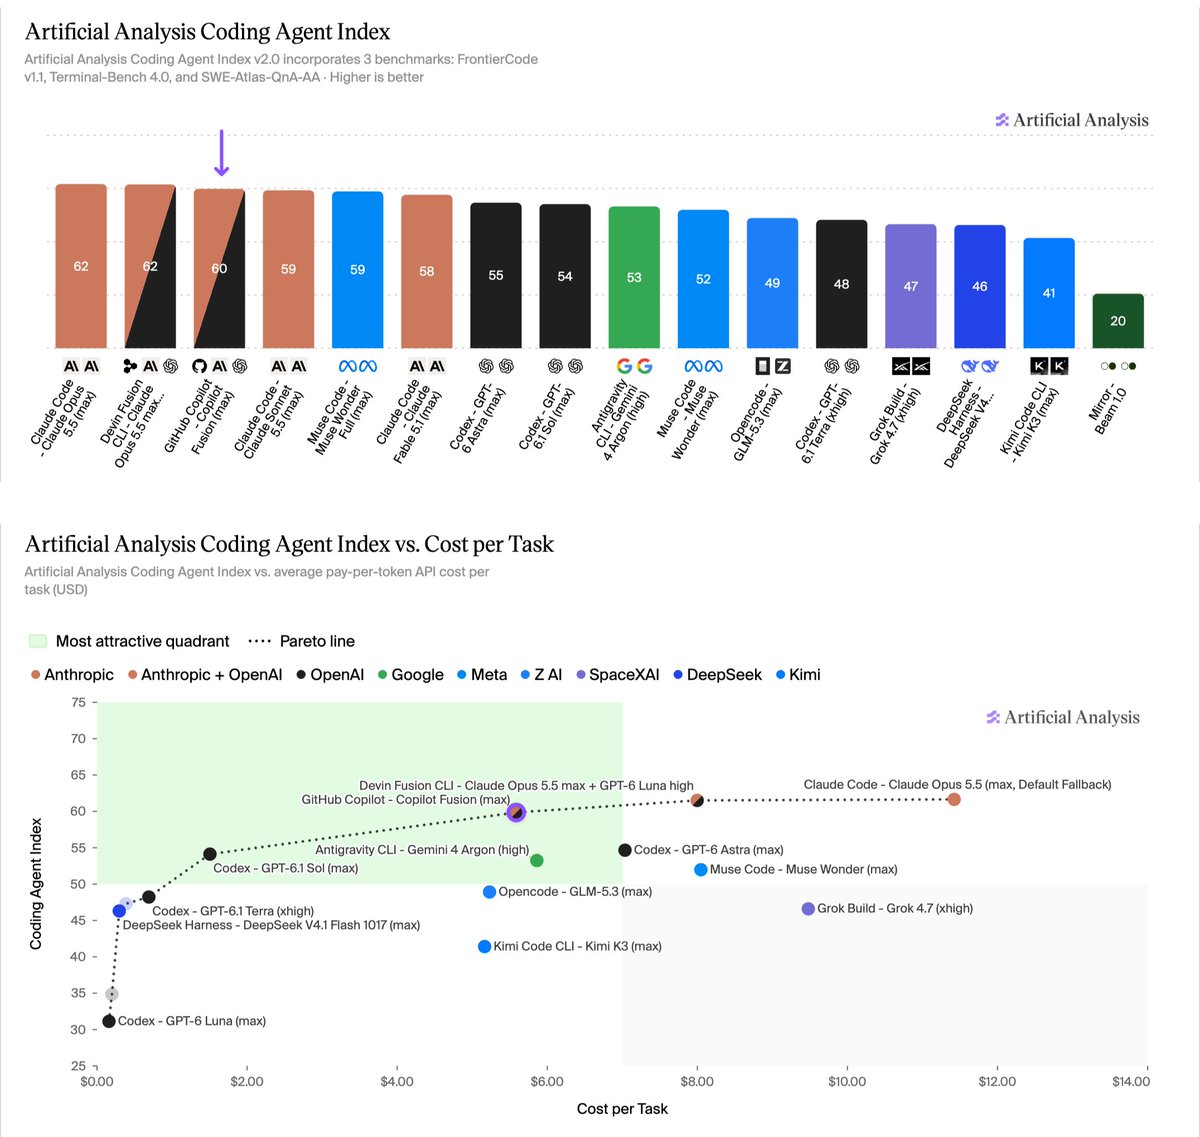
OpenBMB wydaje MiniCPM-OCR, parser dokumentów 1B, oraz model 2B oceniający wyniki OCR
28 października OpenBMB pokazało MiniCPM-OCR na X, działający lokalnie na iPhonie i iPadzie. Model udostępniono z otwartymi wagami; można go uruchamiać za pomocą llama.cpp, vLLM, SGLang lub Ollama. Kod do dostrajania jest open source, a OpenBMB udostępnia również demo i API.AssemblyAI wprowadza swój pierwszy model zamiany tekstu na mowę — AssemblyAI-TTS-1
AssemblyAI wprowadziło AssemblyAI-TTS-1, swój pierwszy model zamiany tekstu na mowę, stworzony z myślą o agentach głosowych. Firma podaje, że model strumieniuje dźwięk z opóźnieniem 90 ms i kosztuje 15 USD za milion znaków. AssemblyAI określa go jako najlepszy model TTS, który można uruchomić na dużą skalę, biorąc pod uwagę jednocześnie dokładność, naturalność i koszt. OpenRouter informuje, że model jest już dostępny na tej platformie, gdzie obsługuje ponad 4000 głosów z USA lub UE.
NVIDIA udostępnia model Nemotron 3.5 Transcribe z otwartymi wagami, który ex aequo zajmuje 1. miejsce wśród modeli Speech-to-Text z otwartymi wagami według Artificial Analysis
Nemotron 3.5 Transcribe od NVIDIA to nowy, dostępny z otwartymi wagami i obsługujący prompty model Speech-to-Text: model typu mixture-of-experts o wielkości 30B, z około 4B aktywnych parametrów. NVIDIA twierdzi, że jeden checkpoint obsługuje transkrypcję w 40 językach, przypisywanie wypowiedzi do mówców, tłumaczenie, podpowiedzi kontekstowe i rozumienie dźwięku, a wagi, dane i receptury są otwarte. Model jest dostępny na Hugging Face, wraz z interaktywnym demem.Mistral udostępnia Responses API w publicznej wersji testowej i oferuje modele DeepSeek V4.1 Flash oraz GLM 5.3 Flash
28 października Mistral ogłosił, że Responses API, przeznaczone do tworzenia agentów na platformie Mistral, jest dostępne w publicznej wersji testowej. Według Mistral każda odpowiedź zwraca odpowiedź modelu, jego rozumowanie i wywołania narzędzi jako osobne elementy, dzięki czemu aplikacja może łatwiej obsługiwać każdy etap niż w przypadku Chat Completions. API działa ze wszystkimi modelami czatowymi hostowanymi przez Mistral, w tym z Large 4. Dokumentacja jest dostępna w serwisie z dokumentacją Mistral Studio.