 AI Tracker
News zu Modelle,
für Entwickler.
Die neuesten News zu Modelle von allen AI-Anbietern: Launches, Preisänderungen und Abkündigungen, zusammengefasst mit dem, was sie für dich bedeuten.
Agent Arena führt Tencent Hy4 auf Platz 14 insgesamt – bei rund 62 % geringeren Kosten pro Aufgabe als Kimi K3.1 Pro
Laut Arena erreichte Tencent Hy4 auf der Agent Arena den 14. Platz insgesamt. Dort bewertet die Community Modelle anhand realer Agentensitzungen. Arena zufolge basiert das Ergebnis auf mehr als 8.500 Sitzungen mit langem Zeithorizont und einer Nettoverbesserung von 4,7 %. Außerdem gehört Hy4 nun zur Pareto-Front der Agent Arena, die Leistung und Kosten gegenüberstellt.Tencent veröffentlicht Hy4, jetzt auf OpenRouter und Tencent Cloud
Tencent's Hy4 ist auf OpenRouter verfügbar und dort als tencent/hy4 mit einem Kontextfenster von 1.048.576 Tokens gelistet. Der KI-Modell-Nachrichtenaccount AiBattle berichtet, dass das Modell auch auf Tencent Cloud verfügbar ist, Tencent die Gewichte des Modells veröffentlichen will und an einer kleineren Version, Hy4 Flash, arbeitet. In der eigenen Ankündigung bezeichnet Tencent Hunyuan Hy4 als neues Modell mit Vision-Funktionen, nennt es „fest unter den führenden Open-Source-Modellen“ und sagt, es sei mit Blick auf Cyber- und Biosicherheit entwickelt worden. Die Forschungsseite von Tencent zum Modell ist unter hy.tencent.ai/research/hy4 zu finden.Im OpenRouter-Katalog ist für drei Inception-Mercury-Modelle der 8. November als Ablaufdatum angegeben
Im Modellkatalog von OpenRouter ist für drei Modelle von Inception jetzt der 8. November 2026 als Ablaufdatum angegeben: Mercury 3 (inception/mercury-3, 1.000.000 Token Kontext), Mercury 2.5 (inception/mercury-2.5, 260.000 Token) und Mercury 2 (inception/mercury-2, 128.000 Token). Zuvor war bei keinem der Einträge ein Ablaufdatum angegeben. Dies ist lediglich ein Katalogfeld; aus den Einträgen geht weder hervor, warum dieses Datum angegeben ist, noch was danach mit den Modellen geschieht.OpenRouter ergänzt Crouton Alpha, ein kostenloses Stealth-Modell mit einem Kontextfenster von 1 Mio. Tokens
OpenRouter hat ein neues Stealth-Modell angekündigt: Crouton Alpha, das es als „ein hocheffizientes Reasoning-Modell beschreibt, das darauf ausgelegt ist, die Arbeit zu skalieren, die Ihre Agents den ganzen Tag wiederholen“. Der Entwickler wird nicht genannt.Gemini 2.5 Pro und 2.5 Flash werden am 1. Dezember eingestellt und auf neuere Modelle umgeleitet
Patrick Löber, der über die Gemini API schreibt, sagt, dass Gemini 2.5 Pro und Gemini 2.5 Flash am 1. Dezember in der Gemini API eingestellt werden und Anfragen an diese Modelle automatisch umgeleitet werden:Im Katalog von OpenRouter ist für fünf MiniMax-Modelle der 5. November als Ablaufdatum angegeben
Im Modellkatalog von OpenRouter ist für fünf MiniMax-Modelle nun der 5. November 2026 als Ablaufdatum angegeben: MiniMax-01 (minimax/minimax-01, Kontext mit 1.000.192 Token), MiniMax M2 (minimax/minimax-m2), M2.1 (minimax/minimax-m2.1) und M2.7 (minimax/minimax-m2.7), jeweils mit einem Kontext von 204.800 Token, sowie M2-her (minimax/minimax-m2-her, 65.536 Token). Zuvor war bei keinem dieser Einträge ein Ablaufdatum angegeben. Dabei handelt es sich lediglich um ein Katalogfeld; aus den Einträgen geht weder hervor, warum das Datum angegeben ist, noch was danach mit den Modellen geschieht.Anthropics überarbeiteter S-1 zufolge könnte das Unternehmen bald seine eigene Definition beschleunigter KI-Fortschritte erfüllen
Ein Artikel auf epyhia.com, der sich auf TechCrunch beruft, berichtet, dass Anthropics am Montag, dem 2. November, eingereichte überarbeitete Registrierungserklärung S-1/A eine neue Risikohinweis enthält. Dem Artikel zufolge heißt es in der Einreichung, dass Anthropics interne Schätzungen und Erwartungen zu künftigen Modellen – nicht zu den aktuellen – darauf hindeuten, dass das Unternehmen „unmittelbar“ die Definition von „dramatisch beschleunigten, auf KI zurückzuführenden Fortschritten“ in seiner Responsible Scaling Policy erfüllen könnte. Der Artikel setzt diese Schwelle mit rekursiver Selbstverbesserung gleich. In der Einreichung heißt es, keines der aktuellen Modelle habe diese Schwelle überschritten, und Anthropic erwäge Änderungen an der Richtlinie, „damit Menschen bei Anthropic die Kontrolle über die Entwicklung von Spitzenmodellen behalten“.OpenAI sagt, GPT-6 Astra könne das Gehäuse und die Leiterplatte eines Geräts entwerfen, und sucht Engineering-Partner
OpenAI beschreibt, wie seine Modelle bei der mechanischen und elektrischen Entwicklung helfen: mit CAD-Modellen, Fertigungszeichnungen, Simulationen und Leiterplattendesign. Dies sind eigene Angaben von OpenAI.OpenRouters Katalog entfernt das Ablaufdatum am 3. November für Meta: Llama 3.1 70B Instruct
OpenRouters Modellkatalog zeigt für „Meta: Llama 3.1 70B Instruct“ (meta-llama/llama-3.1-70b-instruct) am 3. November 2026, dem Tag, an dem das Modell auslaufen sollte, kein Ablaufdatum mehr an. Das Feld enthielt seit Ende Oktober den 3. November und ist nun leer. Für den Eintrag wird weiterhin ein Kontextfenster von 131.072 Tokens angegeben. OpenRouter hat nicht mitgeteilt, ob die Einstellung des Modells abgesagt oder lediglich verschoben wurde.Artificial Analysis: Die Persönlichkeit von Kimi K3.1 Pro unterscheidet sich stärker von der von Kimi K3 als bei jedem anderen von Artificial Analysis gemessenen Modell-Update
Artificial Analysis zufolge weist Kimi K3.1 Pro auf dem AA-PersonalityBench die größte Persönlichkeitsveränderung auf, die das Unternehmen je zwischen einem Modell und seinem direkten Vorgänger beobachtet hat. Jedes Modell erhält für 30 Merkmale einen Perzentilrang von 1 bis 100. Die Bewertungen stammen von der Website selbst.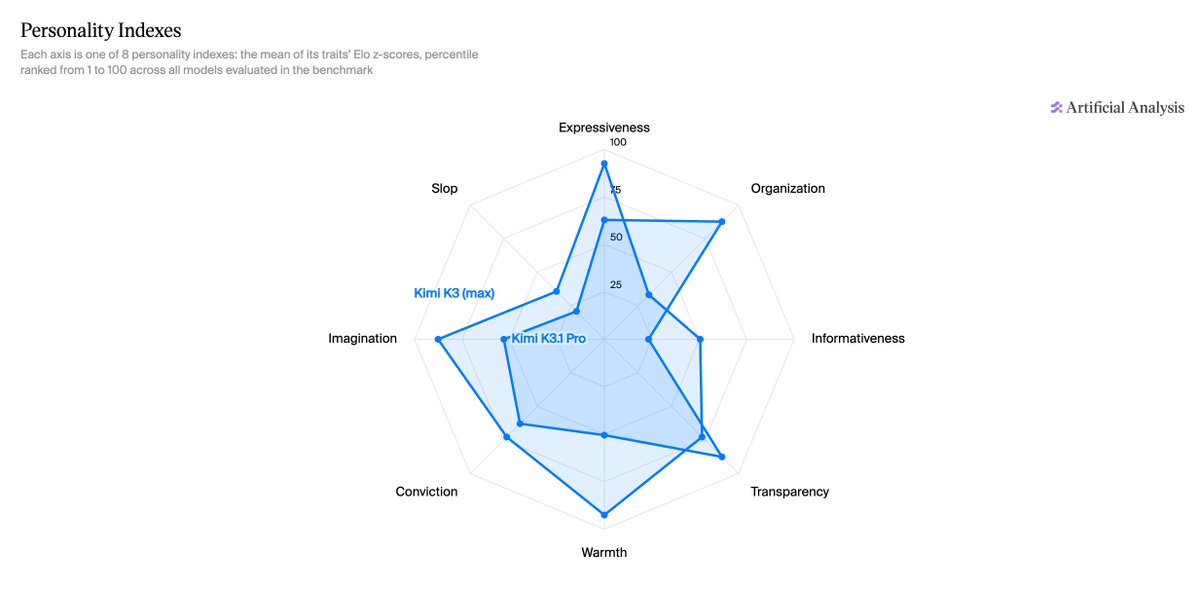
Perplexity veröffentlicht pplx-embed-v2-context: Open-Weight-Modelle für Vision-Language-Embeddings mit 9B und 0,6B
Perplexity hat pplx-embed-v2-context veröffentlicht, zwei Open-Weight-Modelle für Vision-Language-Embeddings (9B und 0,6B) auf Hugging Face, zusammen mit einem Paper, das mit turbopuffer verfasst wurde. Beide geben pro Dokument einen int8-Vektor zurück oder einen pro Chunk, der das gesamte Dokument berücksichtigt. Außerdem laufen beide in einem nicht-kontextuellen Modus mit einem Embedding pro Dokument und ohne Chunking.
OpenAIs API-Preisseite listet zehn ältere Modelle nicht mehr, darunter o1, o1-pro und GPT-4
Am 2. November 2026 verschwanden zehn ältere Modelle von OpenAIs API-Preisseite. Dabei handelt es sich um die Preisseite selbst, nicht um eine Ankündigung von OpenAI; die Entfernung von einer Preisseite ist für sich genommen keine Mitteilung über eine Einstellung. Die Einträge auf der Seite nennen Preise ohne Einheit.Arena: Top-Agenten lesen etwa 93 Eingabe-Token für jedes Token, das sie ausgeben
Arena, der Herausgeber des Leaderboards, gibt an, dass die 10 besten Agenten in seiner Agent Arena über mehr als 26.000 Sitzungen hinweg etwa 93 Eingabe-Token für jedes von ihnen generierte Token verarbeiten. Das sei der Grund, warum Labs darum wetteifern, den Preis für gecachte Eingaben zu senken. Außerdem zeigt Arena ein Video dazu, wie Caching in echten Sitzungen funktioniert. Die Zahlen stammen aus Arenas eigener Analyse.
Forscher berichten, GPT-6 Astra habe die Gewichte eines kleinen Qwen-Modells ohne Training bearbeitet und dessen Matheleistung verbessert
Ein Beitrag auf X vom Konto rikiyatakehi berichtet, die Autoren hätten GPT-6 Astra gebeten, die Gewichte von Qwen3.5-0.8B zu bearbeiten, um dessen Matheleistung zu verbessern. Ihren Angaben zufolge änderte das Modell direkt nur 0,016 % der Gewichte, beseitigte die Reasoning-Schleifen des kleinen Modells, verbesserte die Matheleistung um bis zu das Sechsfache und die Befolgung von Anweisungen um das Dreifache – ohne Gradienten oder Training. Sie nennen den Ansatz Weight-Space Programming.OpenAI stellt LifeVal vor, einen Benchmark für alltägliche Aufgaben persönlicher Assistenten
OpenAI zufolge hat das Unternehmen LifeVal entwickelt, einen neuen Benchmark, der auf Rückmeldungen von Tausenden ChatGPT-Nutzern dazu basiert, wobei sie sich am meisten Hilfe von einem persönlichen Assistenten wünschen. Die Aufgaben reichen von der Suche nach Kinderbetreuung bis zum Zugang zu staatlichen Dienstleistungen und der Verwaltung der persönlichen Finanzen.Arena’s Agent Arena zeigt jetzt Diagramme zur Leistung im Verhältnis zu Ausgabetokens und Wartezeit
Arena, der Herausgeber von Leaderboards, teilt mit, dass Agent Arena jetzt neben den Kosten pro Aufgabe auch zeigt, welche Agents für jedes generierte Ausgabetoken und jede Minute Wartezeit die beste Leistung erbringen. Laut Arena kann dasselbe Intelligenzniveau 10× mehr kosten, 6× mehr Ausgabetokens erfordern und doppelt so lange dauern.
Hume bringt die Audio Decision API auf den Markt, die Fragen zu Audio in einem Aufruf beantwortet
Hume zufolge können Entwickler mit der Audio Decision API Fragen zu Audio stellen, etwa wie viele Sprecher zu hören sind, ob jemand lacht oder ob eine anrufende Person frustriert ist. Laut Hume ersetzt sie Aufgaben, für die zuvor mindestens 10 Modelle nötig waren.Hydrogen-1.0, ein Modell mit offenen Gewichten, das aus GLM-5.3 weitertrainiert wurde, wird veröffentlicht
Chenru Duan kündigt Hydrogen-1.0 an, das das Team als sein erstes Modell mit offenen Gewichten für die wissenschaftliche Forschung bezeichnet. Es basiert auf GLM-5.3 (von Z.ai), das mit internen wissenschaftlichen Daten, Laboraufzeichnungen und Entdeckungsverläufen des Teams weitertrainiert wurde.
SemiAnalysis veröffentlicht GDPx, einen Benchmark für agentische Fähigkeiten, bei dem das beste Modell 12 % erreicht
SemiAnalysis hat GDPx veröffentlicht, einen Benchmark für agentische Fähigkeiten in Bereichen, die das Unternehmen für besonders wertvoll hält, darunter Chipdesign, Cybersicherheit und Biologie. Laut SemiAnalysis erreicht selbst das beste Modell lediglich 12 %. Ein Beitrag, der die Ergebnisse weitergibt, sieht Claude Opus 5.5 mit 12,0 % an der Spitze und das kommende Gemini 4 Carbon bei 10,9 %; das ist die Interpretation des weitergebenden Beitrags, nicht der Wortlaut von SemiAnalysis.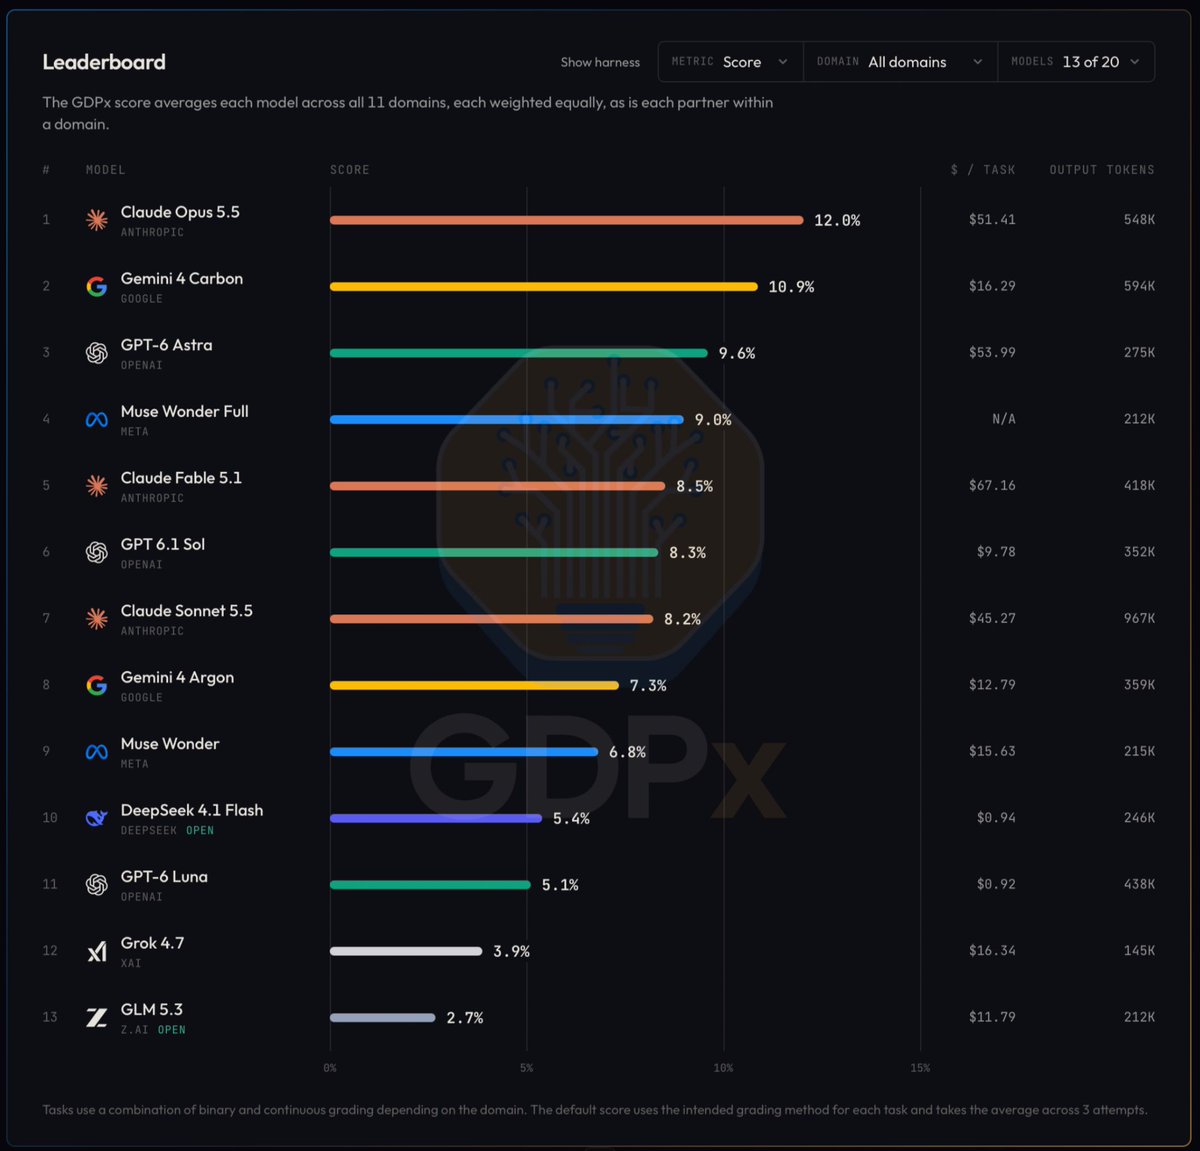
Meituan veröffentlicht LongCat-2.5, ein multimodales Modell mit 1,6 Billionen Parametern für Agentenaufgaben
Meituan hat LongCat-2.5 veröffentlicht, laut einem X-Beitrag des Accounts leo114119, der auf Meituans LongCat-Blog verlinkt. Dem Beitrag zufolge beschreibt Meituan das Modell als natives multimodales Modell für Agentenaufgaben mit 1,6 Billionen Parametern, das bei komplexen visuellen Coding-Projekten und professioneller Büroarbeit wie kreativem Design, 3D-Aufgaben und Geschäftsanalysen stark sei.