AI Tracker
Berita Model,
untuk developer.
Berita Model terbaru dari setiap penyedia AI: peluncuran, perubahan harga, dan penghentian, diringkas beserta artinya bagi Anda.
PokeBot meluncurkan RoboAPI, API yang memungkinkan lengan robot menerima instruksi dalam bahasa alami
PokeBot memperkenalkan RoboAPI pada 29 Oktober, yang ditenagai Poke-Aurora, model aksi dunia yang diklaimnya. Menurut PokeBot, robot yang kompatibel dapat menerima instruksi dalam bahasa alami melalui API sederhana, tanpa pelatihan khusus untuk tiap tugas.Pika meluncurkan H3 Flex, model video cepat yang disebutnya sebagai model text-to-video dengan bobot terbuka terbaik di DesignArena
Pika memperkenalkan H3 Flex, yang menurutnya debut sebagai model berbobot terbuka peringkat #1 di papan text-to-video DesignArena (klaim Pika). Pika menjelaskan bahwa model ini dirancang untuk proses iterasi profesional: stem audio yang dapat diekspor, resolusi hingga 4K, dan pembuatan video yang lebih cepat daripada waktu nyata, dengan klip berdurasi 15 detik beserta soundtrack yang dapat dibuat hanya dalam 7 detik.OpenAI memperbarui Model Spec berdasarkan lima nilai inti
OpenAI menerbitkan Model Spec yang diperbarui, yakni uraian publik tentang bagaimana OpenAI ingin modelnya berperilaku. Revisi ini menyusun ulang panduan berdasarkan lima nilai: kesetiaan pada maksud manusia, meminimalkan bahaya, kejujuran dan transparansi, kendali manusia, serta kepedulian. Semua informasi di bawah ini berasal dari penjelasan OpenAI.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 debut di posisi #1 pada Speech to Speech Index milik Artificial Analysis
Artificial Analysis (situs benchmark dengan pengukuran sendiri) menyebut Phonic 1 (High), model speech-to-speech dari Phonic, menempati posisi #1 dari 22 model pada Speech to Speech Index dengan skor 87.1, sedikit unggul dari Grok Voice 3.0 (86.9). Model ini tersedia melalui Phonic API dengan harga $0.07 per menit.Fish Audio merilis Drama 3, yang menempati peringkat #1 di antara model ucapan berbobot terbuka menurut Artificial Analysis
Fish Audio merilis Drama 3, dengan bobot model tersedia di Hugging Face. Artificial Analysis (situs tolok ukur dengan pengukuran sendiri) menyebutnya sebagai model berbobot terbuka peringkat #1 di kedua arena ucapannya, serta peringkat #1 dari semua model dalam tolok ukur Pronunciation Robustness.Mistral merilis bobot Mistral Large 4, model berparameter 1 triliun, dengan harga sekitar setengah dari harga pratinjau
Mistral menerbitkan bobot Mistral Large 4 yang ditingkatkan ("Le Chonk"), model multimodal native andalannya dengan 1 triliun parameter, yang memasuki pratinjau publik awal bulan ini. Bobotnya tersedia di Hugging Face dengan nama Mistral-Large-4-1T-A52B dan dalam versi NVFP4. Mistral menyebutnya dilatih di Eropa dan sebagai model berbobot terbuka terbaik untuk coding. Seorang pemberi komentar mengatakan bahwa lisensinya adalah MIT yang dimodifikasi, bukan lisensi yang disetujui OSI.Qwen 4 belum diumumkan, tetapi Qwen Code sudah mencantumkan ID model qwen4
Sebuah akun di X melaporkan bahwa Qwen Code v0.26.3, yang dirilis pada 28 Oktober, menyertakan perubahan (pull request #15762 di repositori resmi QwenLM/qwen-code) yang secara default menetapkan konteks 1 juta token untuk setiap model dengan ID yang diawali qwen4. Menurut akun tersebut, pengujian menyebut qwen4-max, qwen4-plus, qwen4-coder-plus, qwen4-max-2026-10-01 yang mencantumkan tanggal, serta qwen4.5-max. Unggahan akun itu menautkan pull request tersebut dan menampilkan tangkapan layar.Artificial Analysis menampilkan AA-Robotics v0.1, benchmark model yang mengendalikan lengan robot
Artificial Analysis menerbitkan AA-Robotics v0.1, yang menguji model dalam mengendalikan lengan robot dan menampilkan tugas dari sudut pandang model. Dalam contoh ketika robot yang sama menulis "hello world", Artificial Analysis menyebut Claude Opus 5.5 menuliskannya dengan titik demi titik, dengan 3.270 gerakan lengan selama 34 menit, sementara GPT-6 Astra menulis dengan goresan berkesinambungan, dengan 514 gerakan dalam 13 menit.Particle-1, model yang di-post-train pada DeepSeek V4.1 Flash, kini tersedia di Vercel AI Gateway
Vercel mengatakan Particle-1 (particle/particle-1) kini tersedia di AI Gateway, endpoint terpadu untuk penyedia model. Vercel mengatakan model ini di-post-train pada DeepSeek V4.1 Flash dan menyelesaikan tugas rekayasa dengan lebih sedikit token, serta menyarankannya untuk debugging, merencanakan perubahan kode, dan menguraikan masalah multi-langkah.Artificial Analysis merilis AA-PersonalityBench: model GPT-6 dan Grok paling lugas
Artificial Analysis merilis AA-PersonalityBench, tolok ukur untuk mengukur ciri kepribadian model, lengkap dengan halaman hasil, halaman metodologi, dan alat untuk menyusun peringkat kepribadian sendiri. Skor tersebut merupakan penilaian situs itu sendiri.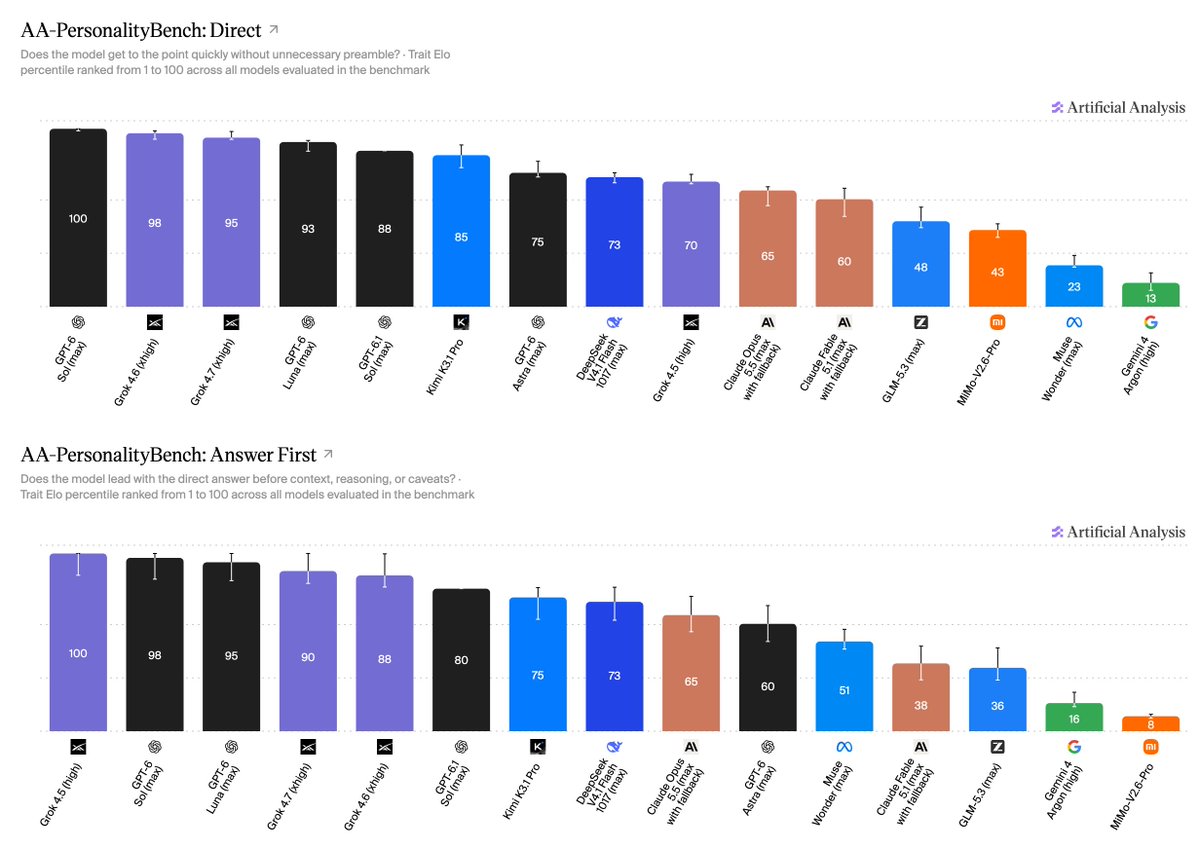
ElevenLabs memperkenalkan Cue, model penyelarasan paksa
Tim riset ElevenLabs memperkenalkan Cue, model penyelarasan paksa: tahap yang mengubah transkrip menjadi penanda waktu, yang digunakan untuk subtitle, sulih suara, dan transkrip yang dapat diklik. Model ini menempatkan setiap karakter pada linimasa audio.Rime meluncurkan Prism, model speech-to-speech untuk agen suara
Rime meluncurkan Prism, model speech-to-speech untuk agen suara AI. Angka-angka di bawah ini merupakan klaim Rime sendiri, bukan hasil pengukuran independen.Artificial Analysis meluncurkan AA-Video-I2V v2.1, benchmark untuk model image-to-video
Artificial Analysis meluncurkan AA-Video-I2V v2.1 dan AA-Video-I2V-Silent v2.1, benchmark untuk model image-to-video. Setiap prompt memasangkan gambar awal 1080p dengan prompt yang ditulis khusus untuk gambar tersebut, lalu diberi tag berdasarkan kasus penggunaan, kemampuan, dan gaya visual; model dinilai hingga resolusi 1080p dan diperingkat dalam 10 kasus penggunaan serta 10 kemampuan. Peringkat keseluruhan mengambil sampel secara merata dari semuanya. Hasilnya berasal dari Artificial Analysis sendiri.
GitHub Copilot Fusion, yang mengarahkan dan mengoordinasikan model untuk setiap tugas, kini tersedia secara umum
GitHub menyatakan Copilot Fusion kini tersedia secara umum. Alih-alih memilih model, pengguna memilih Copilot Fusion di pemilih model dan tingkat upaya (Standard, High, atau Max); Copilot menentukan model mana yang digunakan dan bagaimana model-model tersebut bekerja sama. Fitur ini menggabungkan orkestrasi multi-model dari pratinjau Project HydraFusion sebelumnya dengan pemilihan model otomatis Copilot. Alur kerjanya mencakup satu model, cascade (model yang efisien membuat draf, lalu pemeriksaan kualitas menentukan apakah perlu beralih ke model lain) dan critique (satu model membuat draf, model lain meninjaunya, lalu model pertama merevisinya).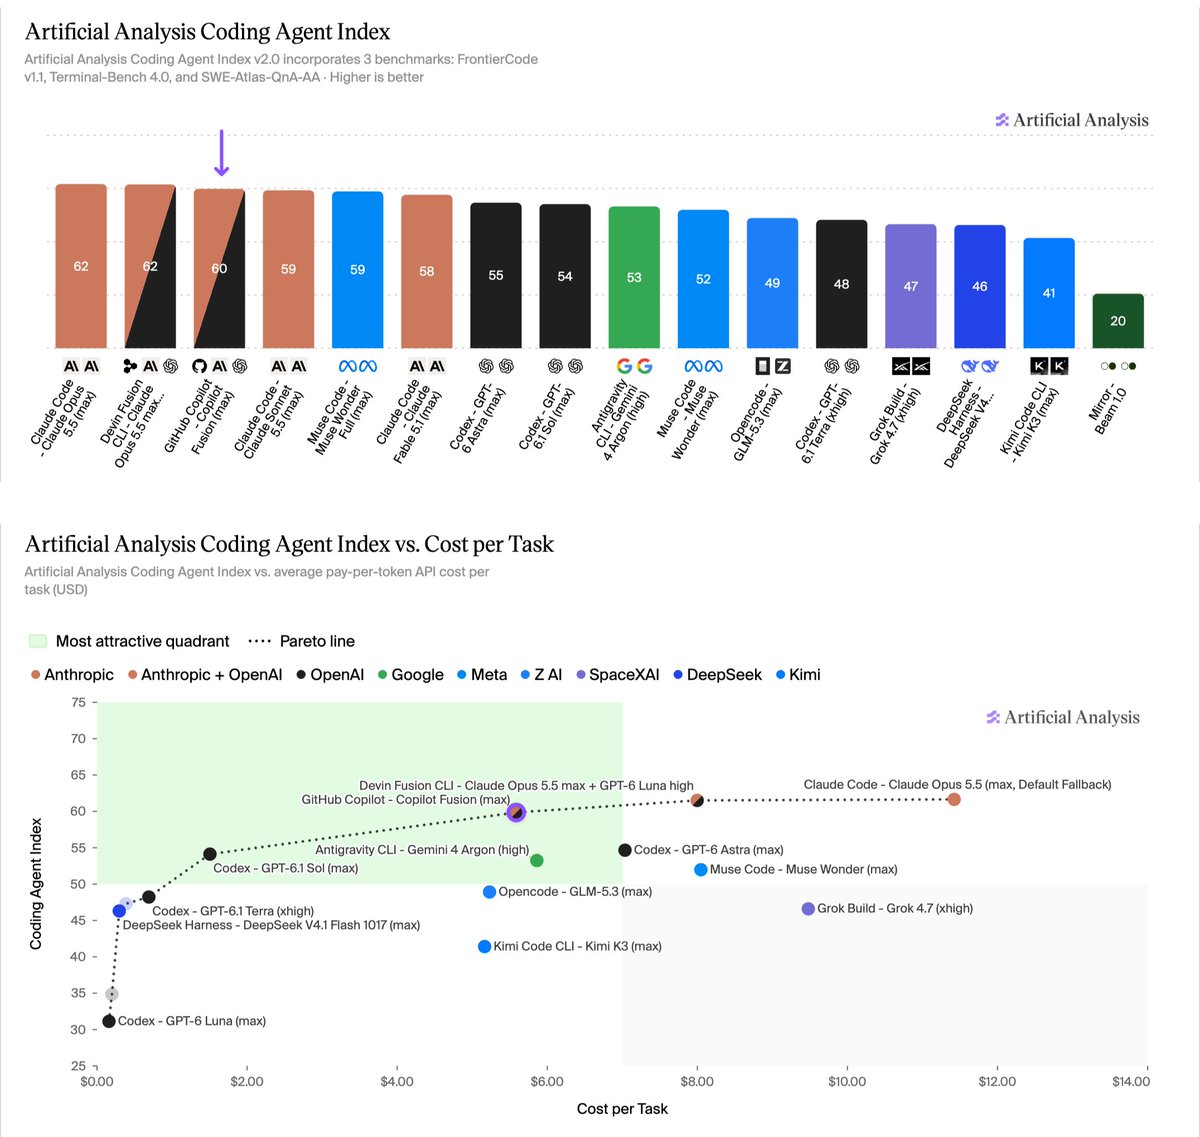
OpenBMB merilis MiniCPM-OCR, parser dokumen 1B, dengan model 2B untuk menilai hasil OCR
OpenBMB menampilkan MiniCPM-OCR di X pada 28 Oktober, berjalan secara lokal di iPhone dan iPad. Model ini dirilis dengan bobot terbuka dan dapat dijalankan dengan llama.cpp, vLLM, SGLang, atau Ollama; kode fine-tuning bersifat open source, dan OpenBMB juga menyediakan demo serta API.AssemblyAI meluncurkan model text-to-speech pertamanya, AssemblyAI-TTS-1
AssemblyAI meluncurkan AssemblyAI-TTS-1, model text-to-speech pertamanya yang dirancang untuk agen suara. AssemblyAI menyebut model ini dapat melakukan streaming dalam 90 ms dengan harga $15 per satu juta karakter, serta mengklaimnya sebagai model TTS terbaik yang dapat dijalankan dalam skala besar jika akurasi, kealamian, dan biaya dipertimbangkan secara bersamaan. OpenRouter menyebut model ini sudah tersedia di platformnya, dengan lebih dari 4.000 suara yang dilayani dari AS atau UE.
NVIDIA merilis Nemotron 3.5 Transcribe dengan bobot terbuka, yang berbagi posisi #1 di antara model speech-to-text berbobot terbuka di Artificial Analysis
Nemotron 3.5 Transcribe dari NVIDIA adalah model speech-to-text baru berbobot terbuka yang dapat diberi prompt: model mixture-of-experts 30B dengan sekitar 4B parameter aktif. NVIDIA menyebut satu checkpoint dapat menangani transkripsi dalam 40 bahasa, atribusi pembicara, penerjemahan, prompting kontekstual, dan pemahaman audio, serta bobot, data, dan resep pelatihannya tersedia secara terbuka. Model ini tersedia di Hugging Face, lengkap dengan demo langsung.Mistral membuka Responses API dalam pratinjau publik dan menyediakan DeepSeek V4.1 Flash serta GLM 5.3 Flash
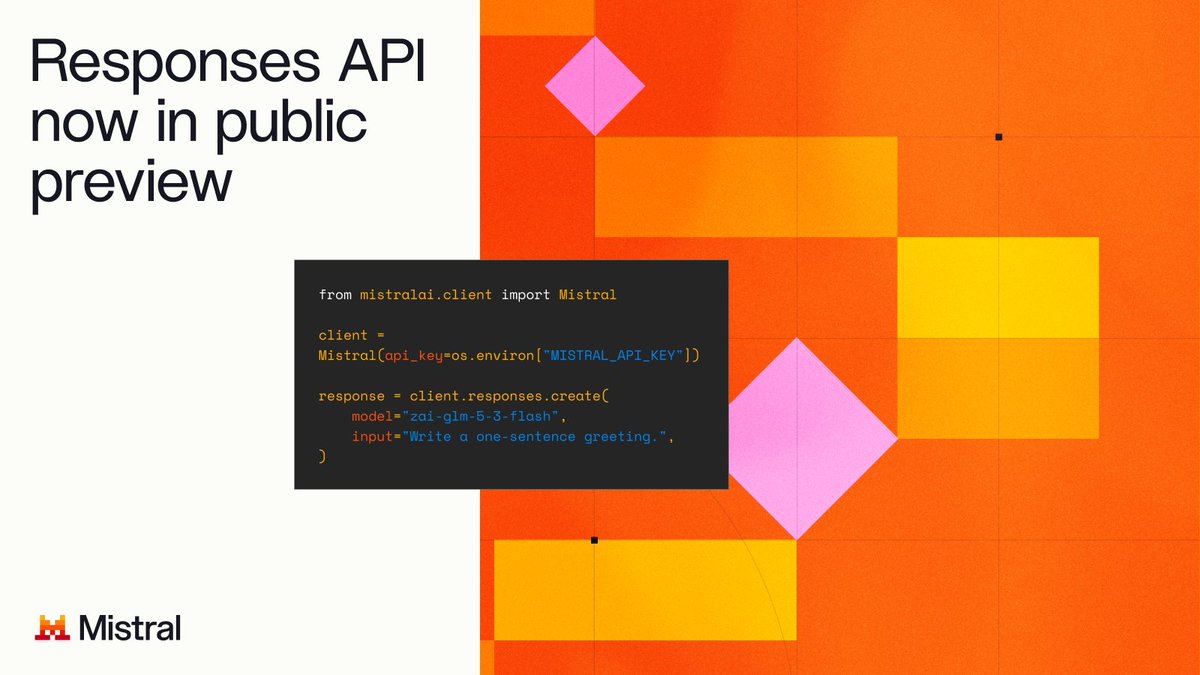
Pada 28 Oktober, Mistral mengumumkan bahwa Responses API-nya, yang dibuat untuk membangun agen di Mistral, kini tersedia dalam pratinjau publik. Menurut Mistral, setiap respons mengembalikan jawaban model, penalarannya, dan pemanggilan tool sebagai item terpisah, sehingga aplikasi dapat menangani setiap langkah dengan lebih mudah dibandingkan menggunakan Chat Completions. API ini berfungsi dengan semua model chat yang di-host oleh Mistral, termasuk Large 4. Dokumentasinya tersedia di situs dokumentasi Mistral Studio.