AI Tracker
Noticias de modelos,
para desarrolladores.
Lo último en modelos de todos los proveedores de IA: lanzamientos, cambios de precio y retiradas, resumidos con lo que significan para ti.
PokeBot lanza RoboAPI, una API que permite dar instrucciones en lenguaje natural a brazos robóticos
PokeBot presentó RoboAPI el 29 de octubre, impulsada por Poke-Aurora, su modelo de acciones en el mundo. Afirma que los robots compatibles pueden recibir instrucciones en lenguaje natural a través de una API sencilla, sin entrenamiento específico para cada tarea.Pika lanza H3 Flex, un modelo de video rápido que, según afirma, es el mejor modelo de texto a video de pesos abiertos en DesignArena
Pika presentó H3 Flex, que, según afirma, debuta como el modelo de pesos abiertos n.º 1 en la clasificación de texto a video de DesignArena (afirmación de Pika). Describe el modelo como diseñado para la iteración profesional: pistas de audio exportables, resoluciones de hasta 4K y generación más rápida que en tiempo real, con un clip de 15 segundos y su banda sonora en tan solo 7 segundos.OpenAI actualiza su Model Spec en torno a cinco valores fundamentales
OpenAI publicó una versión actualizada de Model Spec, su descripción pública de cómo quiere que se comporten sus modelos. La revisión reorganiza las directrices en torno a cinco valores: fidelidad a la intención humana, minimización del daño, honestidad y transparencia, autonomía humana y cuidado. Todo lo que sigue es la versión de OpenAI.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 debuta en el puesto n.º 1 del Speech to Speech Index de Artificial Analysis
Artificial Analysis (un sitio de evaluación comparativa que realiza sus propias mediciones) afirma que Phonic 1 (High), el modelo de conversión de voz a voz de Phonic, ocupa el puesto n.º 1 de 22 en su Speech to Speech Index, con una puntuación de 87,1, apenas por delante de Grok Voice 3.0 (86,9). El modelo está disponible a través de la API de Phonic por $0.07 por minuto.Fish Audio lanza Drama 3, que Artificial Analysis sitúa en el puesto n.º 1 entre los modelos de voz con pesos abiertos
Fish Audio lanzó Drama 3, con los pesos disponibles en Hugging Face. Artificial Analysis (un sitio de evaluación comparativa, según sus propias mediciones) afirma que es el modelo n.º 1 con pesos abiertos en sus dos arenas de voz y el n.º 1 entre todos los modelos en su prueba de Robustez de pronunciación.Mistral publica los pesos de Mistral Large 4, un modelo de 1 billón de parámetros, a aproximadamente la mitad del precio de la vista previa
Mistral publicó los pesos de una versión mejorada de Mistral Large 4 («Le Chonk»), su modelo insignia nativamente multimodal de 1 billón de parámetros, que entró en vista previa pública a principios de este mes. Los pesos están en Hugging Face como Mistral-Large-4-1T-A52B y en una versión NVFP4. Mistral lo describe como entrenado en Europa y como el mejor modelo de pesos abiertos para programación. Un comentarista dice que la licencia es una MIT modificada, no aprobada por la OSI.Qwen 4 aún no se ha anunciado, pero Qwen Code ya incluye identificadores de modelos qwen4
Una cuenta de X informa que Qwen Code v0.26.3, publicada el 28 de octubre, incluye un cambio (pull request #15762 en el repositorio oficial QwenLM/qwen-code) que asigna por defecto un contexto de 1 millón de tokens a todos los modelos cuyo identificador empieza por qwen4. Según esa cuenta, las pruebas mencionan qwen4-max, qwen4-plus, qwen4-coder-plus, qwen4-max-2026-10-01 (con fecha) y qwen4.5-max. La publicación de la cuenta enlaza el pull request y muestra una captura de pantalla.Artificial Analysis muestra AA-Robotics v0.1, un benchmark de modelos que controlan un brazo robótico
Artificial Analysis publicó AA-Robotics v0.1, donde los modelos controlan un brazo robótico y se muestra la tarea desde el punto de vista del modelo. En un ejemplo en el que el mismo robot escribe «hello world», Artificial Analysis dice que Claude Opus 5.5 lo escribió a toquecitos, punto por punto, con 3,270 movimientos del brazo en 34 minutos, mientras que GPT-6 Astra escribió con trazos continuos, con 514 movimientos en 13 minutos.Particle-1, un modelo posentrenado con DeepSeek V4.1 Flash, ya está disponible en Vercel AI Gateway
Vercel afirma que Particle-1 (particle/particle-1) ya está disponible en AI Gateway, su punto de acceso unificado a proveedores de modelos. Según Vercel, el modelo está posentrenado con DeepSeek V4.1 Flash y completa tareas de ingeniería con menos tokens; la empresa lo recomienda para depurar, planificar cambios de código y desglosar problemas de varios pasos.Artificial Analysis publica AA-PersonalityBench: GPT-6 y los modelos de Grok son los más directos
Artificial Analysis publicó AA-PersonalityBench, un benchmark de rasgos de personalidad de modelos, con una página de resultados, una página sobre la metodología y una herramienta para crear tu propia clasificación de personalidad. Las puntuaciones son propias del sitio.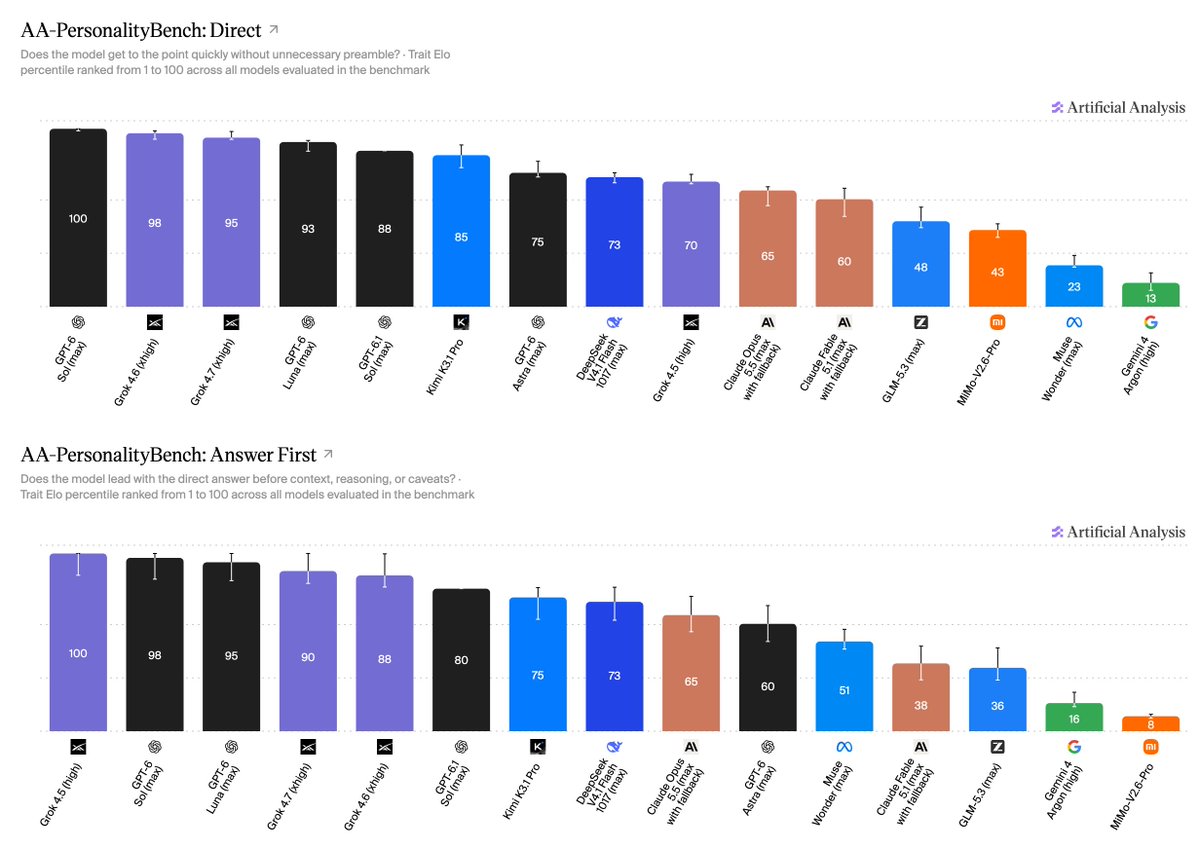
ElevenLabs presenta Cue, un modelo de alineación forzada
El equipo de investigación de ElevenLabs presentó Cue, un modelo de alineación forzada: el paso que convierte una transcripción en marcas de tiempo, utilizado para subtítulos, doblaje y transcripciones interactivas. Sitúa cada carácter en la línea de tiempo del audio.Rime lanza Prism, un modelo de voz a voz para agentes de voz
Rime lanzó Prism, un modelo de voz a voz para agentes de voz con IA. Las cifras que aparecen a continuación son afirmaciones de Rime, no mediciones independientes.Artificial Analysis lanza AA-Video-I2V v2.1, un benchmark para modelos de imagen a video
Artificial Analysis lanzó AA-Video-I2V v2.1 y AA-Video-I2V-Silent v2.1, un benchmark para modelos de imagen a video. Cada prompt combina una imagen inicial en 1080p con un prompt escrito para ella, y está etiquetado por caso de uso, capacidad y estilo visual; los modelos se evalúan hasta 1080p y se clasifican en 10 casos de uso y 10 capacidades. La clasificación general toma muestras equitativas de todas estas categorías. Los resultados son de Artificial Analysis.
GitHub Copilot Fusion, que enruta y coordina modelos para cada tarea, ya está disponible de forma general
GitHub anuncia que Copilot Fusion ya está disponible de forma general. En lugar de elegir un modelo, el usuario selecciona Copilot Fusion en el selector de modelos y un nivel de esfuerzo (Standard, High o Max); Copilot decide qué modelos usar y cómo trabajan juntos. Combina la coordinación de varios modelos de la vista previa anterior de Project HydraFusion con la selección automática de modelos de Copilot. Los flujos de trabajo incluyen un solo modelo, una cascada (un modelo eficiente prepara un borrador y una comprobación de calidad decide si hay que escalar) y una revisión crítica (un modelo prepara un borrador, otro lo revisa y el primero lo modifica).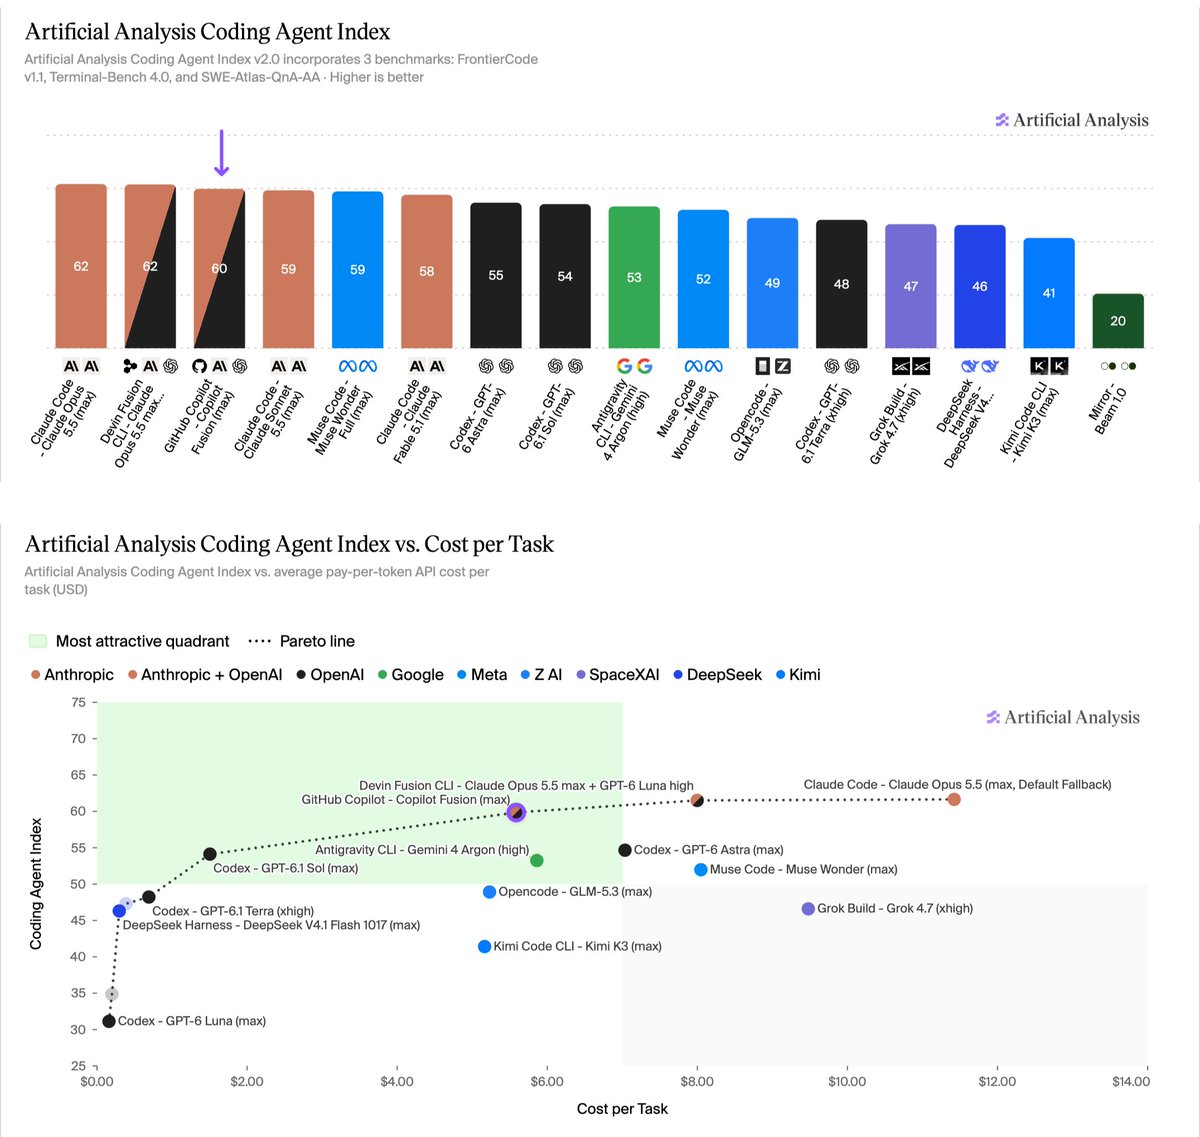
OpenBMB lanza MiniCPM-OCR, un parser de documentos de 1B, junto con un modelo de 2B que puntúa los resultados de OCR
OpenBMB mostró MiniCPM-OCR en X el 28 de octubre, ejecutándose localmente en un iPhone y un iPad. Se lanza con pesos abiertos y puede ejecutarse con llama.cpp, vLLM, SGLang u Ollama; el código de ajuste fino es de código abierto, y OpenBMB también ofrece una demo y una API.AssemblyAI lanza su primer modelo de texto a voz, AssemblyAI-TTS-1
AssemblyAI lanzó AssemblyAI-TTS-1, su primer modelo de texto a voz, diseñado para agentes de voz. AssemblyAI afirma que transmite en 90 ms por $15 por millón de caracteres y lo considera el mejor modelo de TTS que se puede ejecutar a escala si se tienen en cuenta conjuntamente la precisión, la naturalidad y el coste. OpenRouter dice que el modelo ya está disponible allí, con más de 4.000 voces ofrecidas desde EE. UU. o la UE.
NVIDIA lanza Nemotron 3.5 Transcribe, de pesos abiertos, que empata en el puesto n.º 1 entre los modelos de voz a texto de pesos abiertos según Artificial Analysis
Nemotron 3.5 Transcribe de NVIDIA es un nuevo modelo de voz a texto de pesos abiertos y guiable mediante prompts: una mezcla de expertos de 30B con unos 4B de parámetros activos. NVIDIA afirma que un único checkpoint permite transcribir en 40 idiomas, atribuir intervenciones a hablantes, traducir, usar prompts contextuales y comprender audio, y que los pesos, los datos y las recetas son abiertos. Está disponible en Hugging Face y cuenta con una demo en vivo.Mistral abre una Responses API en versión preliminar pública y ofrece DeepSeek V4.1 Flash y GLM 5.3 Flash
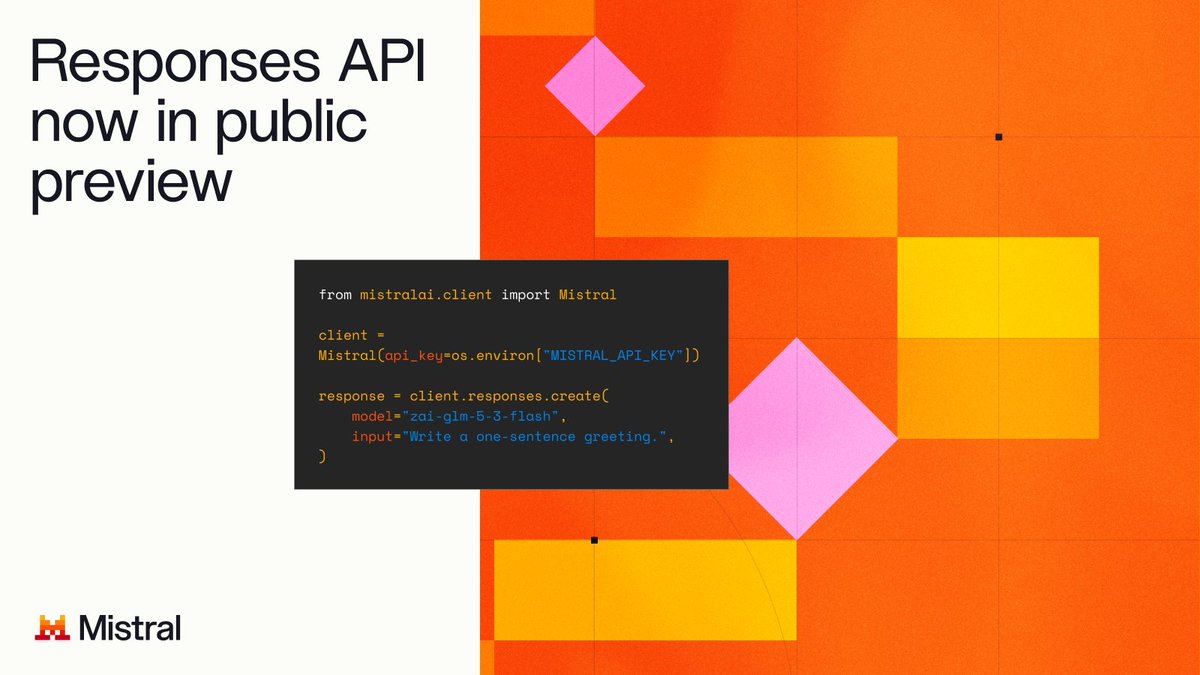
Mistral anunció el 28 de octubre que su Responses API, diseñada para crear agentes en Mistral, está en versión preliminar pública. Según Mistral, cada respuesta devuelve la contestación del modelo, su razonamiento y sus llamadas a herramientas como elementos separados, para que una aplicación pueda gestionar cada paso con más facilidad que con Chat Completions. Funciona con todos los modelos de chat alojados por Mistral, incluido Large 4. La documentación está en el sitio de documentación de Mistral Studio.