AI Tracker
Models समाचार,
डेवलपर्स के लिए।
हर AI provider से Models से जुड़ी ताज़ा ख़बरें: लॉन्च, कीमत में बदलाव और बंद होने वाली सेवाएँ, संक्षेप में और आपके लिए उनका मतलब।
PokeBot ने RoboAPI लॉन्च किया, एक API जो रोबोटिक भुजाओं को प्राकृतिक भाषा में निर्देश देती है
PokeBot ने 29 अक्टूबर को RoboAPI पेश किया, जो Poke-Aurora पर आधारित है—कंपनी इसे अपना world-action model कहती है। उसका कहना है कि संगत रोबोट बिना किसी कार्य-विशिष्ट प्रशिक्षण के, एक सरल API के ज़रिए प्राकृतिक भाषा में दिए गए निर्देश ले सकते हैं।Pika ने H3 Flex लॉन्च किया, एक तेज़ वीडियो मॉडल जिसे वह DesignArena पर शीर्ष ओपन-वेट टेक्स्ट-टू-वीडियो मॉडल बताती है
Pika ने H3 Flex पेश किया, जिसके बारे में उसका कहना है कि यह DesignArena के टेक्स्ट-टू-वीडियो बोर्ड पर #1 ओपन-वेट मॉडल के रूप में डेब्यू करता है (Pika का दावा)। कंपनी इसे पेशेवर स्तर पर बार-बार सुधार करने के लिए बना मॉडल बताती है: एक्सपोर्ट किए जा सकने वाले ऑडियो स्टेम, 4K तक के रिज़ॉल्यूशन और रियल-टाइम से तेज़ जनरेशन—जिसमें 15 सेकंड की क्लिप और साउंडट्रैक सिर्फ़ 7 सेकंड में बनाए जा सकते हैं।OpenAI ने पाँच मूल्यों के इर्द-गिर्द अपना Model Spec अपडेट किया
OpenAI ने अपडेट किया हुआ Model Spec प्रकाशित किया है—यह इस बात का सार्वजनिक विवरण है कि वह अपने मॉडलों से कैसा व्यवहार चाहता है। संशोधन में दिशानिर्देशों को पाँच मूल्यों के इर्द-गिर्द फिर से व्यवस्थित किया गया है: मानवीय मंशा के प्रति निष्ठा, हानि को कम करना, ईमानदारी और पारदर्शिता, मानवीय स्वायत्तता और परवाह। नीचे दी गई हर बात OpenAI के अपने विवरण पर आधारित है।OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Artificial Analysis के Speech to Speech Index में Phonic 1 ने #1 स्थान पर शुरुआत की
Artificial Analysis (एक बेंचमार्क साइट, जिसके आंकड़े उसके अपने माप पर आधारित हैं) के अनुसार, Phonic का speech-to-speech मॉडल Phonic 1 (High), उसके Speech to Speech Index में 87.1 अंकों के साथ 22 मॉडलों में #1 पर है—Grok Voice 3.0 (86.9) से मामूली आगे। यह मॉडल Phonic API के ज़रिए $0.07 प्रति मिनट पर उपलब्ध है।Fish Audio ने Drama 3 जारी किया; Artificial Analysis की रैंकिंग में यह ओपन-वेट स्पीच मॉडल्स में #1 है
Fish Audio ने Drama 3 जारी किया, जिसके वेट्स Hugging Face पर उपलब्ध हैं। Artificial Analysis (एक बेंचमार्क साइट, जिसके अपने माप हैं) के अनुसार, यह उसके दोनों स्पीच एरीना में #1 ओपन-वेट मॉडल है और उसके Pronunciation Robustness बेंचमार्क पर सभी मॉडलों में #1 है।Mistral ने Mistral Large 4 के वेट्स जारी किए—1 ट्रिलियन पैरामीटर वाला मॉडल, प्रीव्यू कीमत से लगभग आधी कीमत पर
Mistral ने बेहतर Mistral Large 4 ("Le Chonk") के वेट्स प्रकाशित किए। यह उसका 1 ट्रिलियन पैरामीटर वाला फ्लैगशिप, नेटिवली मल्टीमॉडल मॉडल है, जिसका पब्लिक प्रीव्यू इसी महीने की शुरुआत में शुरू हुआ था। वेट्स Hugging Face पर Mistral-Large-4-1T-A52B और NVFP4 वर्ज़न के रूप में उपलब्ध हैं। Mistral इसे यूरोप में प्रशिक्षित और कोडिंग के लिए सबसे अच्छा ओपन-वेट मॉडल बताता है। एक टिप्पणीकार का कहना है कि इसका लाइसेंस संशोधित MIT है, OSI-अनुमोदित लाइसेंस नहीं।Qwen 4 की घोषणा नहीं हुई है, लेकिन Qwen Code में पहले से qwen4 मॉडल आईडी सूचीबद्ध हैं
X पर एक अकाउंट की रिपोर्ट के मुताबिक, 28 अक्टूबर को जारी Qwen Code v0.26.3 में एक बदलाव (आधिकारिक QwenLM/qwen-code रिपॉज़िटरी में pull request #15762) शामिल है, जो qwen4 से शुरू होने वाली हर मॉडल आईडी के लिए डिफ़ॉल्ट रूप से 1M-token context मानता है। उस अकाउंट के अनुसार, टेस्ट में qwen4-max, qwen4-plus, qwen4-coder-plus, तारीख वाले qwen4-max-2026-10-01 और qwen4.5-max नाम शामिल हैं। अकाउंट की पोस्ट में pull request का लिंक और एक स्क्रीनशॉट है।Artificial Analysis ने AA-Robotics v0.1 पेश किया, जो रोबोटिक आर्म को नियंत्रित करने वाले मॉडल्स का बेंचमार्क है
Artificial Analysis ने AA-Robotics v0.1 प्रकाशित किया, जिसमें मॉडल्स एक रोबोटिक आर्म को नियंत्रित करते हैं और काम को मॉडल के नज़रिए से दिखाया जाता है। एक उदाहरण में, जहां वही रोबोट "hello world" लिखता है, Artificial Analysis के मुताबिक Claude Opus 5.5 ने अक्षर को बिंदु-बिंदु करके लिखा—34 मिनट में आर्म की 3,270 चालों के साथ—जबकि GPT-6 Astra ने लगातार स्ट्रोक में लिखा—13 मिनट में 514 चालों के साथ।DeepSeek V4.1 Flash पर पोस्ट-ट्रेन किया गया मॉडल Particle-1 अब Vercel AI Gateway पर उपलब्ध है
Vercel का कहना है कि Particle-1 (particle/particle-1) अब AI Gateway पर उपलब्ध है, जो मॉडल प्रदाताओं के लिए उसका एकीकृत एंडपॉइंट है। Vercel के मुताबिक, इस मॉडल को DeepSeek V4.1 Flash पर पोस्ट-ट्रेन किया गया है और यह इंजीनियरिंग के काम कम टोकन में पूरा करता है। कंपनी इसे डीबगिंग, कोड में बदलाव की योजना बनाने और कई चरणों वाली समस्याओं को छोटे हिस्सों में बाँटने के लिए सुझाती है।Artificial Analysis ने AA-PersonalityBench प्रकाशित किया: GPT-6 और Grok मॉडल सबसे सीधे हैं
Artificial Analysis ने AA-PersonalityBench प्रकाशित किया—यह मॉडल के व्यक्तित्व गुणों का एक बेंचमार्क है। इसके साथ नतीजों का एक पेज, कार्यप्रणाली का एक पेज और अपनी व्यक्तित्व रैंकिंग बनाने का एक टूल भी है। स्कोर इस साइट के अपने हैं।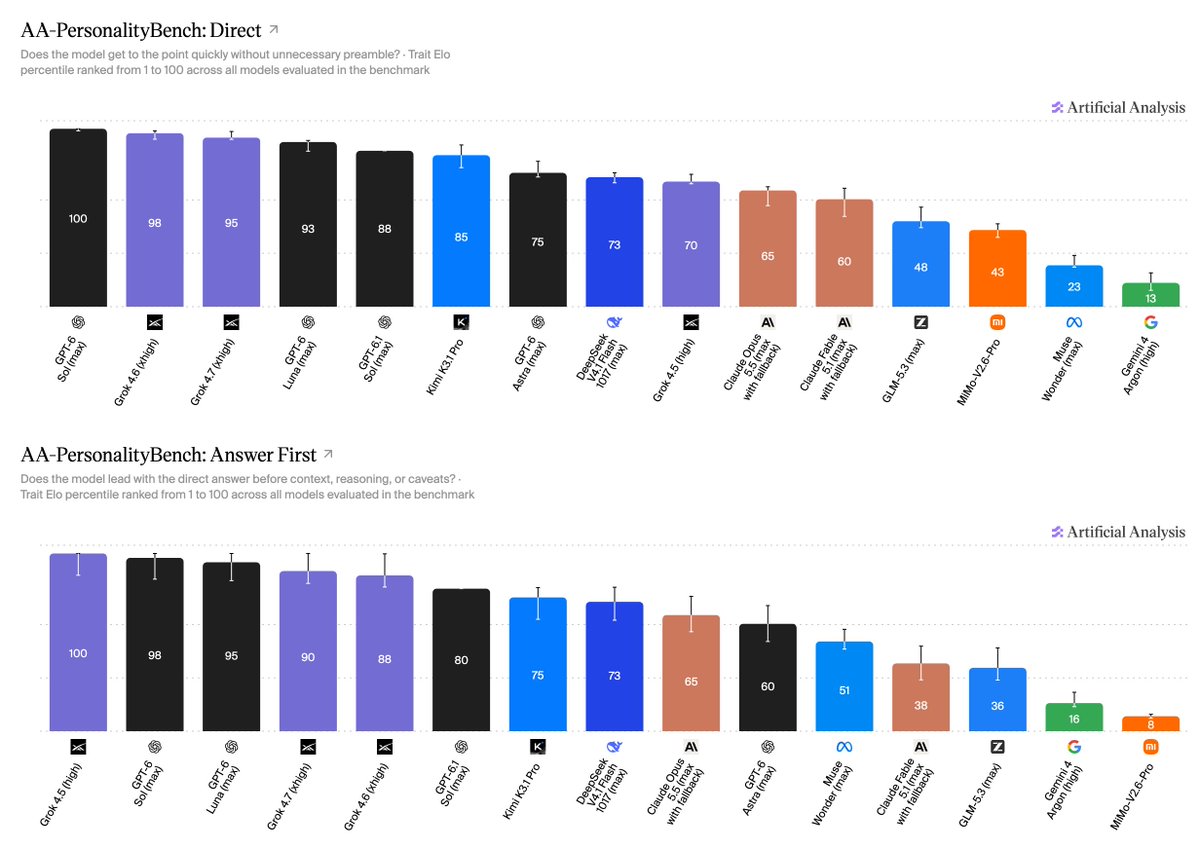
ElevenLabs ने Cue पेश किया, एक forced alignment मॉडल
ElevenLabs रिसर्च ने Cue पेश किया—एक forced alignment मॉडल, जो ट्रांसक्रिप्ट को टाइमस्टैम्प में बदलता है। इसका इस्तेमाल सबटाइटल, डबिंग और क्लिक किए जा सकने वाले ट्रांसक्रिप्ट के लिए होता है। यह हर अक्षर को ऑडियो की टाइमलाइन पर रखता है।Rime ने Prism लॉन्च किया, वॉइस एजेंट्स के लिए स्पीच-टू-स्पीच मॉडल
Rime ने AI वॉइस एजेंट्स के लिए स्पीच-टू-स्पीच मॉडल Prism लॉन्च किया। नीचे दिए गए आंकड़े Rime के अपने दावे हैं, स्वतंत्र रूप से मापे गए नतीजे नहीं।Artificial Analysis ने इमेज-टू-वीडियो मॉडल्स के लिए AA-Video-I2V v2.1 बेंचमार्क लॉन्च किया
Artificial Analysis ने इमेज-टू-वीडियो मॉडल्स के लिए AA-Video-I2V v2.1 और AA-Video-I2V-Silent v2.1 लॉन्च किए। हर प्रॉम्प्ट में 1080p की एक शुरुआती इमेज और उसके लिए लिखा गया प्रॉम्प्ट शामिल है, और उसे उपयोग के मामले, क्षमता तथा विज़ुअल शैली के आधार पर टैग किया गया है; मॉडल्स का मूल्यांकन 1080p तक के रिज़ॉल्यूशन पर किया जाता है और 10 उपयोग मामलों तथा 10 क्षमताओं में उनकी रैंकिंग होती है। कुल रैंकिंग में इन सभी को समान रूप से शामिल किया जाता है। ये नतीजे Artificial Analysis के अपने हैं।
GitHub Copilot Fusion, जो हर काम के लिए मॉडल रूट और ऑर्केस्ट्रेट करता है, अब आम तौर पर उपलब्ध है
GitHub का कहना है कि Copilot Fusion अब आम तौर पर उपलब्ध है। मॉडल चुनने के बजाय, उपयोगकर्ता मॉडल पिकर में Copilot Fusion और एक प्रयास स्तर (Standard, High या Max) चुनता है; Copilot तय करता है कि कौन-से मॉडल इस्तेमाल करने हैं और वे मिलकर कैसे काम करेंगे। यह पहले के Project HydraFusion प्रीव्यू के मल्टी-मॉडल ऑर्केस्ट्रेशन को Copilot के ऑटो मॉडल चयन के साथ जोड़ता है। वर्कफ़्लो में एक अकेला मॉडल, एक कैस्केड (एक कुशल मॉडल ड्राफ़्ट तैयार करता है और गुणवत्ता जाँच यह तय करती है कि आगे बढ़ना है या नहीं) और क्रिटीक (एक मॉडल ड्राफ़्ट तैयार करता है, दूसरा उसकी समीक्षा करता है और पहला उसमें संशोधन करता है) शामिल हैं।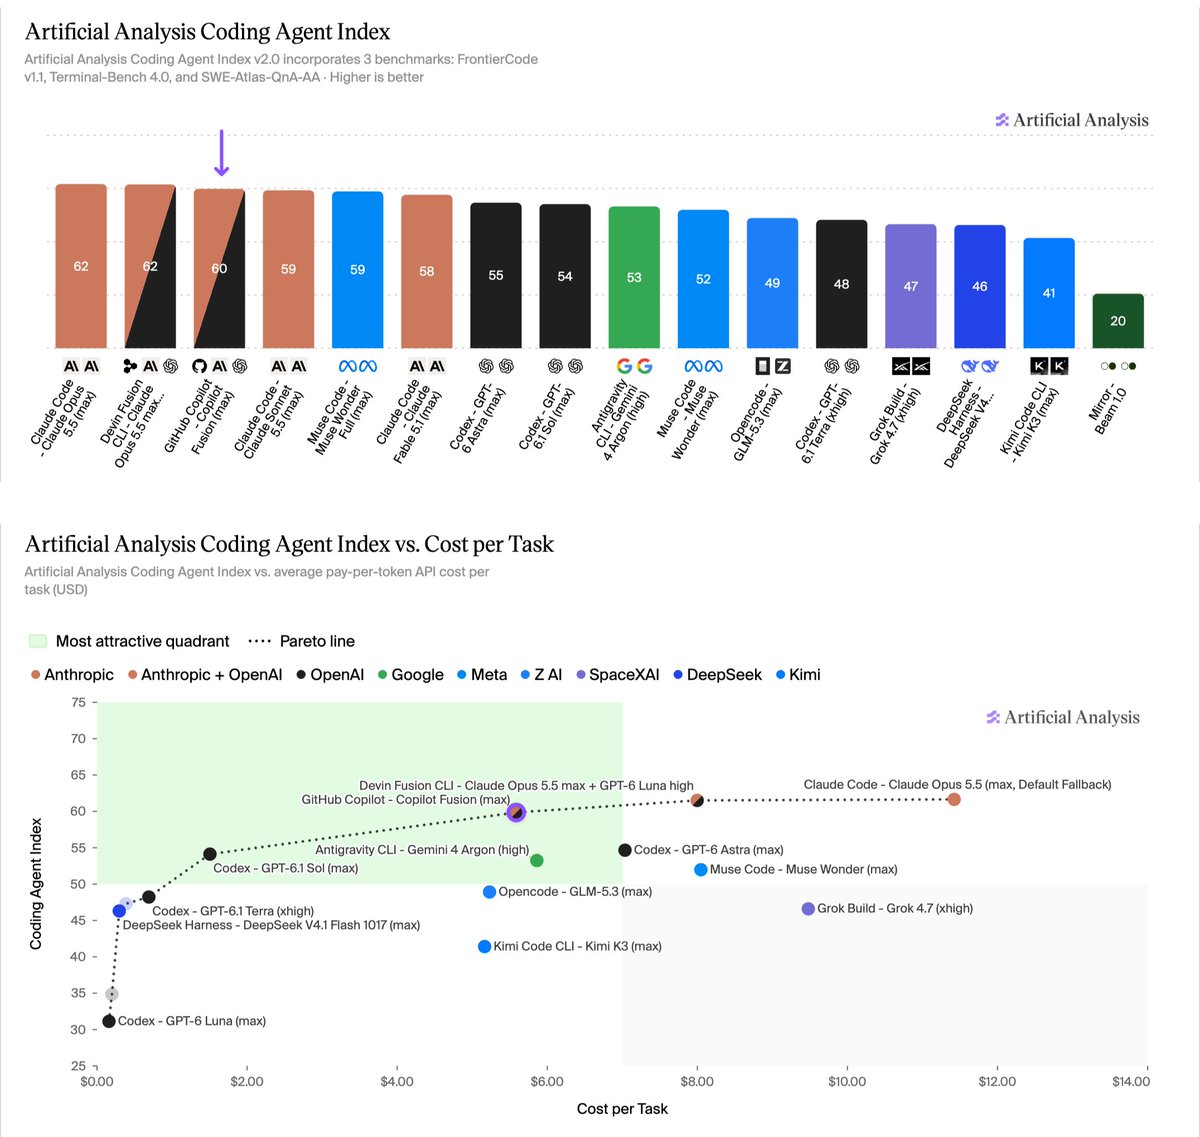
OpenBMB ने MiniCPM-OCR जारी किया: 1B दस्तावेज़ पार्सर, साथ में OCR नतीजों को स्कोर करने वाला 2B मॉडल
OpenBMB ने 28 अक्टूबर को X पर MiniCPM-OCR दिखाया, जो iPhone और iPad पर स्थानीय रूप से चल रहा था। इसे खुले वज़न के साथ जारी किया गया है और यह llama.cpp, vLLM, SGLang या Ollama के साथ चल सकता है; fine-tuning कोड ओपन सोर्स है, और OpenBMB एक डेमो और API भी उपलब्ध कराता है।AssemblyAI ने अपना पहला टेक्स्ट-टू-स्पीच मॉडल, AssemblyAI-TTS-1 लॉन्च किया
AssemblyAI ने AssemblyAI-TTS-1 लॉन्च किया, जो उसका पहला टेक्स्ट-टू-स्पीच मॉडल है और वॉइस एजेंट्स के लिए बनाया गया है। AssemblyAI का कहना है कि यह $15 प्रति दस लाख अक्षरों की दर से 90 ms में स्ट्रीम करता है और सटीकता, स्वाभाविकता तथा लागत—तीनों को साथ में देखते हुए इसे बड़े पैमाने पर चलाया जा सकने वाला सबसे अच्छा TTS मॉडल बताता है। OpenRouter का कहना है कि यह मॉडल वहाँ उपलब्ध है और इसमें अमेरिका या EU से 4,000+ आवाज़ें दी जाती हैं।
NVIDIA ने ओपन-वेट Nemotron 3.5 Transcribe जारी किया, जो Artificial Analysis पर ओपन-वेट स्पीच-टू-टेक्स्ट मॉडल में #1 स्थान साझा करता है
NVIDIA का Nemotron 3.5 Transcribe एक नया ओपन-वेट, प्रॉम्प्ट से निर्देशित किया जा सकने वाला स्पीच-टू-टेक्स्ट मॉडल है: 30B का mixture-of-experts, जिसमें लगभग 4B सक्रिय पैरामीटर हैं। NVIDIA के अनुसार, एक ही चेकपॉइंट 40 भाषाओं में ट्रांसक्रिप्शन, वक्ता की पहचान, अनुवाद, संदर्भ-आधारित प्रॉम्प्टिंग और ऑडियो की समझ संभालता है; साथ ही, वेट, डेटा और रेसिपी खुले हैं। यह Hugging Face पर उपलब्ध है और इसका लाइव डेमो भी है।Mistral ने Responses API को सार्वजनिक प्रीव्यू में पेश किया और DeepSeek V4.1 Flash तथा GLM 5.3 Flash उपलब्ध कराए
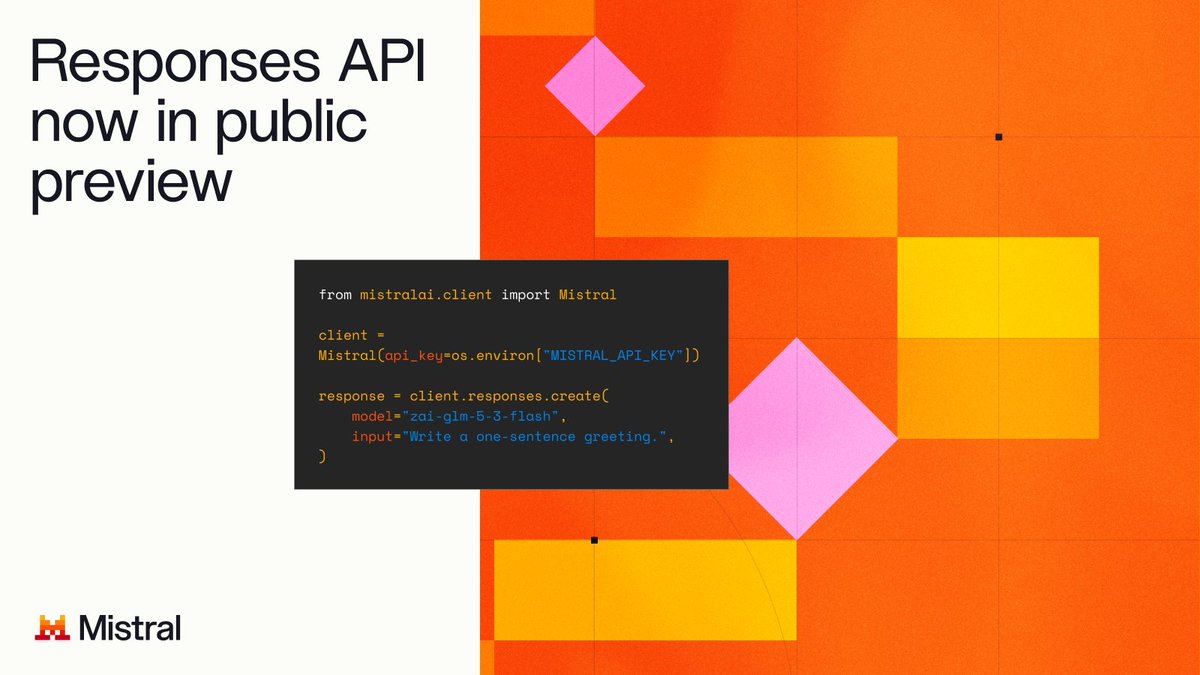
Mistral ने 28 अक्टूबर को घोषणा की कि Mistral पर एजेंट बनाने के लिए तैयार उसका Responses API सार्वजनिक प्रीव्यू में है। Mistral के अनुसार, हर प्रतिक्रिया में मॉडल का जवाब, उसका तर्क और उसके टूल कॉल अलग-अलग आइटम के रूप में लौटते हैं, जिससे कोई ऐप Chat Completions की तुलना में हर चरण को अधिक आसानी से संभाल सकता है। यह Mistral पर होस्ट किए गए सभी चैट मॉडल के साथ काम करता है, जिनमें Large 4 भी शामिल है। दस्तावेज़ Mistral की Studio docs साइट पर उपलब्ध हैं।