AI Tracker
모델 뉴스,
개발자를 위해.
모든 AI 제공업체의 최신 모델 뉴스: 출시, 가격 변경, 지원 종료를 나에게 미치는 영향과 함께 요약했습니다.
PokeBot, 로봇 팔에 자연어로 지시하는 API RoboAPI 출시
PokeBot은 10월 29일 Robo-Aurora를 기반으로 한 RoboAPI를 공개했습니다. PokeBot은 Robo-Aurora를 자사의 월드 액션 모델이라고 부릅니다. 회사에 따르면 호환되는 로봇은 작업별 학습 없이 간단한 API를 통해 자연어 지시를 수행할 수 있습니다.Pika, DesignArena에서 최고의 오픈 웨이트 텍스트-투-비디오 모델이라고 자사가 밝힌 고속 비디오 모델 H3 Flex 출시
Pika는 H3 Flex를 공개하며, 자사 주장에 따르면 DesignArena의 텍스트-투-비디오 순위표에서 오픈 웨이트 모델 중 1위로 데뷔한다고 밝혔습니다. Pika는 이 모델이 전문적인 반복 작업을 위해 설계됐다고 설명합니다. 오디오 스템 내보내기, 최대 4K 해상도, 실시간보다 빠른 생성이 가능하며, 15초 분량의 영상과 사운드트랙을 단 7초 만에 만들 수 있습니다.OpenAI, Model Spec을 다섯 가지 핵심 가치에 맞춰 업데이트
OpenAI가 모델의 행동 방침을 공개적으로 설명하는 문서인 Model Spec의 업데이트 버전을 발표했습니다. 이번 개정에서는 지침을 다섯 가지 가치에 따라 재구성했습니다. 인간의 의도에 대한 충실성, 피해 최소화, 정직성과 투명성, 인간의 주체성, 배려입니다. 아래 내용은 모두 OpenAI의 설명입니다.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1, Artificial Analysis의 Speech to Speech Index에서 1위로 데뷔
Artificial Analysis(자체 측정치를 사용하는 벤치마크 사이트)에 따르면 Phonic의 음성 간 모델 Phonic 1 (High)이 Speech to Speech Index에서 87.1점으로 22개 모델 중 1위를 차지해 Grok Voice 3.0(86.9점)을 근소한 차이로 앞섰습니다. 이 모델은 Phonic API를 통해 분당 $0.07에 이용할 수 있습니다.Fish Audio, Artificial Analysis가 오픈 웨이트 음성 모델 중 1위로 꼽은 Drama 3 출시
Fish Audio가 Hugging Face에 가중치를 공개하며 Drama 3를 출시했습니다. 벤치마크 사이트 Artificial Analysis의 자체 측정 결과에 따르면 Drama 3는 두 음성 아레나 모두에서 오픈 웨이트 모델 중 1위이며, Pronunciation Robustness 벤치마크에서는 전체 모델 중 1위입니다.Mistral, Mistral Large 4의 가중치 공개… 1조 매개변수 모델, 프리뷰 가격의 약 절반
Mistral은 개선된 Mistral Large 4(“Le Chonk”)의 가중치를 공개했다. 이 모델은 이번 달 초 공개 프리뷰를 시작한 1조 매개변수 규모의 주력 네이티브 멀티모달 모델이다. 가중치는 Hugging Face에 Mistral-Large-4-1T-A52B와 NVFP4 버전으로 공개됐다. Mistral은 이 모델이 유럽에서 학습됐으며 코딩용 오픈 웨이트 모델 중 최고라고 소개한다. 한 댓글 작성자는 라이선스가 OSI 승인을 받지 않은 수정 MIT 라이선스라고 지적했다.Qwen 4는 아직 발표되지 않았지만 Qwen Code에는 이미 qwen4 모델 ID가 나열돼 있다
X 계정 한 곳에 따르면 10월 28일 출시된 Qwen Code v0.26.3에는 공식 QwenLM/qwen-code 저장소의 변경 사항(풀 리퀘스트 #15762)이 포함돼 있으며, 이 변경 사항은 ID가 qwen4로 시작하는 모든 모델에 기본적으로 1M 토큰 컨텍스트를 적용한다. 해당 계정에 따르면 테스트에는 qwen4-max, qwen4-plus, qwen4-coder-plus, 날짜가 포함된 qwen4-max-2026-10-01, qwen4.5-max가 명시돼 있다. 해당 계정의 게시물에는 풀 리퀘스트 링크와 스크린샷이 포함돼 있다.Artificial Analysis, 로봇 팔을 제어하는 모델 벤치마크 AA-Robotics v0.1 공개
Artificial Analysis가 모델이 로봇 팔을 제어하고 모델 관점에서 작업을 보여주는 AA-Robotics v0.1을 공개했습니다. 같은 로봇이 "hello world"를 쓰는 예시에서, Artificial Analysis에 따르면 Claude Opus 5.5는 점을 하나씩 찍어 글자를 썼으며 팔을 3,270번 움직이는 데 34분이 걸렸습니다. 반면 GPT-6 Astra는 연속된 획으로 써서 514번 움직이는 데 13분이 걸렸습니다.DeepSeek V4.1 Flash를 기반으로 후속 학습한 모델 Particle-1, 이제 Vercel AI Gateway에서 제공
Vercel에 따르면 Particle-1(particle/particle-1)을 이제 모델 제공업체용 통합 엔드포인트인 AI Gateway에서 사용할 수 있습니다. Vercel은 이 모델이 DeepSeek V4.1 Flash를 기반으로 후속 학습했으며 더 적은 토큰으로 엔지니어링 작업을 수행한다고 밝혔습니다. 디버깅, 코드 변경 계획 수립, 여러 단계로 이뤄진 문제 분석에 이 모델을 사용할 것을 권장합니다.Artificial Analysis, AA-PersonalityBench 공개: GPT-6 및 Grok 모델이 가장 직설적
Artificial Analysis가 모델의 성격 특성을 평가하는 벤치마크 AA-PersonalityBench를 공개했습니다. 결과 페이지와 방법론 페이지, 나만의 성격 순위를 만들 수 있는 도구도 함께 제공됩니다. 점수는 해당 사이트 자체 평가입니다.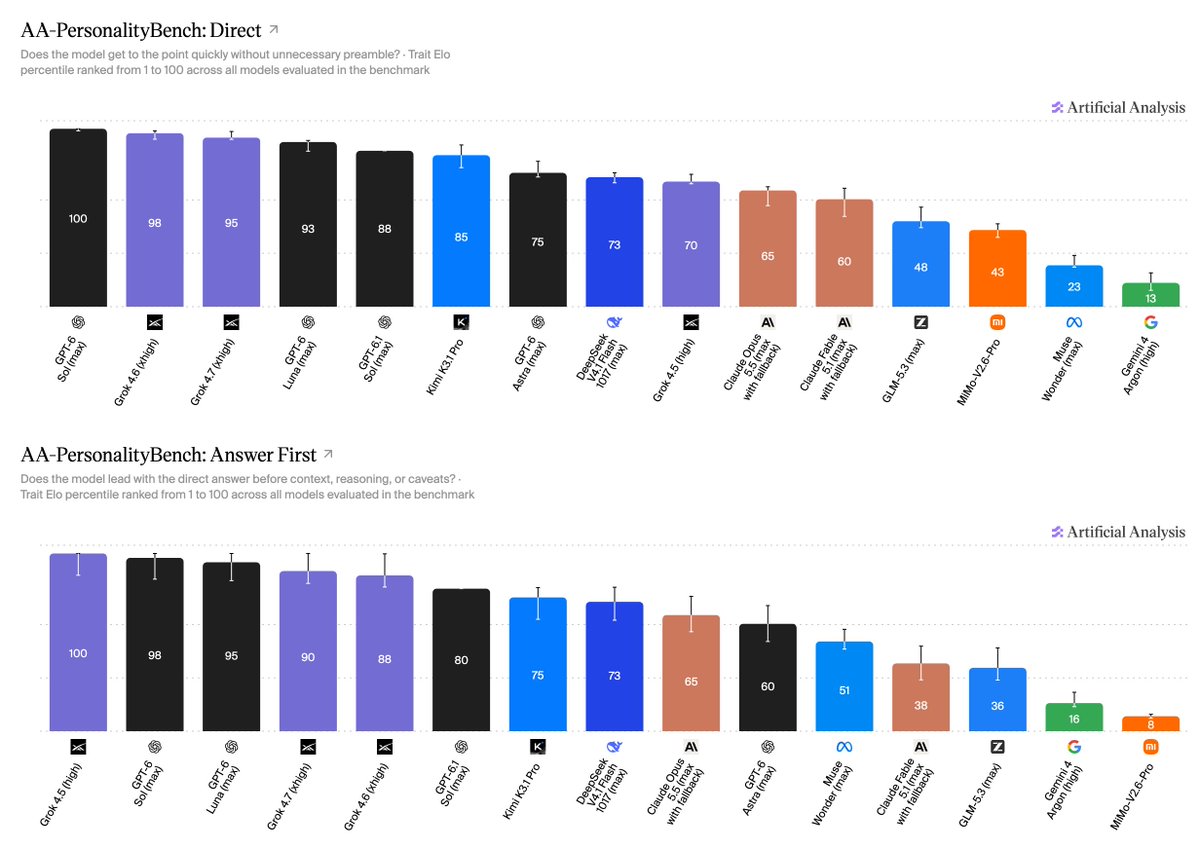
ElevenLabs introduces Cue, a forced alignment model
ElevenLabs research introduced Cue, a forced alignment model: the step that turns a transcript into timestamps, used for subtitles, dubbing and clickable transcripts. It places every character on the audio timeline.Rime, 음성 에이전트용 음성 간 모델 Prism 출시
Rime이 AI 음성 에이전트를 위한 음성 간 모델 Prism을 출시했습니다. 아래 수치는 독립적으로 측정된 결과가 아니라 Rime의 자체 주장입니다.Artificial Analysis, 이미지-투-비디오 모델 벤치마크 AA-Video-I2V v2.1 출시
Artificial Analysis는 이미지-투-비디오 모델 벤치마크인 AA-Video-I2V v2.1과 AA-Video-I2V-Silent v2.1을 출시했습니다. 각 프롬프트는 1080p 시작 이미지와 해당 이미지에 맞춰 작성된 프롬프트를 짝지으며, 사용 사례, 기능, 시각 스타일별로 태그가 지정됩니다. 모델은 최대 1080p에서 평가되며 10개 사용 사례와 10개 기능에 걸쳐 순위가 매겨집니다. 종합 순위는 각 항목을 균등하게 표본 추출합니다. 결과는 Artificial Analysis 자체 평가입니다.
각 작업에 맞춰 모델을 선택하고 조율하는 GitHub Copilot Fusion, 정식 출시
GitHub가 Copilot Fusion의 정식 출시를 발표했습니다. 사용자는 모델을 직접 고르는 대신 모델 선택기에서 Copilot Fusion과 작업 강도(Standard, High 또는 Max)를 선택하면 됩니다. 그러면 Copilot이 사용할 모델과 모델 간 협업 방식을 결정합니다. 이전 Project HydraFusion 프리뷰의 멀티모델 조율 기능에 Copilot의 자동 모델 선택을 결합한 제품입니다. 워크플로에는 단일 모델, 캐스케이드(효율적인 모델이 초안을 작성하고 품질 검사 결과에 따라 상위 단계로 넘길지 결정)와 비평(한 모델이 초안을 작성하고 다른 모델이 검토한 뒤 첫 모델이 수정)이 포함됩니다.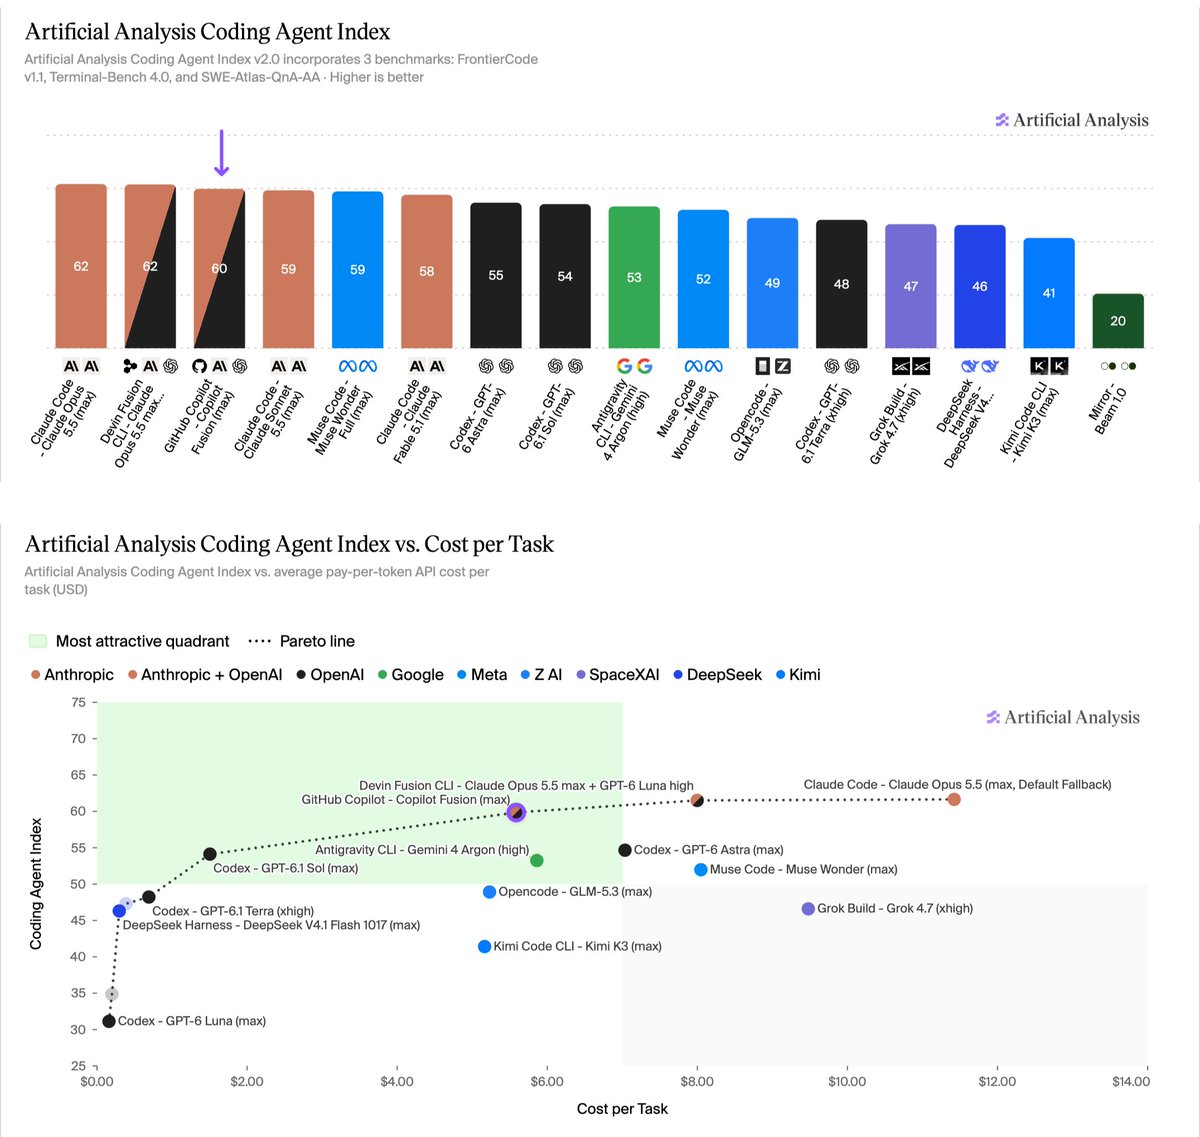
OpenBMB, OCR 결과를 평가하는 2B 모델과 함께 1B 문서 파서 MiniCPM-OCR 출시
OpenBMB는 10월 28일 X에서 iPhone과 iPad에서 로컬로 실행되는 MiniCPM-OCR을 선보였습니다. 오픈 웨이트로 공개됐으며 llama.cpp, vLLM, SGLang 또는 Ollama로 실행할 수 있습니다. 파인튜닝 코드도 오픈 소스로 공개됐고, OpenBMB는 데모와 API도 제공합니다.AssemblyAI, 첫 텍스트 음성 변환 모델 AssemblyAI-TTS-1 출시
AssemblyAI가 음성 에이전트용으로 제작한 첫 텍스트 음성 변환 모델 AssemblyAI-TTS-1을 출시했습니다. AssemblyAI는 이 모델이 90ms 만에 스트리밍되고 문자 100만 개당 15달러이며, 정확도와 자연스러움, 비용을 종합했을 때 대규모로 사용할 수 있는 최고의 TTS 모델이라고 밝혔습니다. OpenRouter에 따르면 이 모델은 해당 플랫폼에서 제공되며, 미국 또는 EU에서 4,000개 이상의 음성을 지원합니다.
NVIDIA, 오픈 웨이트 Nemotron 3.5 Transcribe 출시…Artificial Analysis 오픈 웨이트 음성-텍스트 모델 공동 1위
NVIDIA의 Nemotron 3.5 Transcribe는 프롬프트 입력이 가능한 새로운 오픈 웨이트 음성-텍스트 모델로, 활성 파라미터 약 4B 규모의 30B 혼합 전문가 모델입니다. NVIDIA는 단일 체크포인트로 40개 언어의 전사, 화자 식별, 번역, 문맥 기반 프롬프트 입력, 오디오 이해를 처리할 수 있으며, 가중치와 데이터, 레시피를 공개한다고 밝혔습니다. Hugging Face에서 이용할 수 있으며 라이브 데모도 제공됩니다.Mistral opens a Responses API in public preview and serves DeepSeek V4.1 Flash and GLM 5.3 Flash
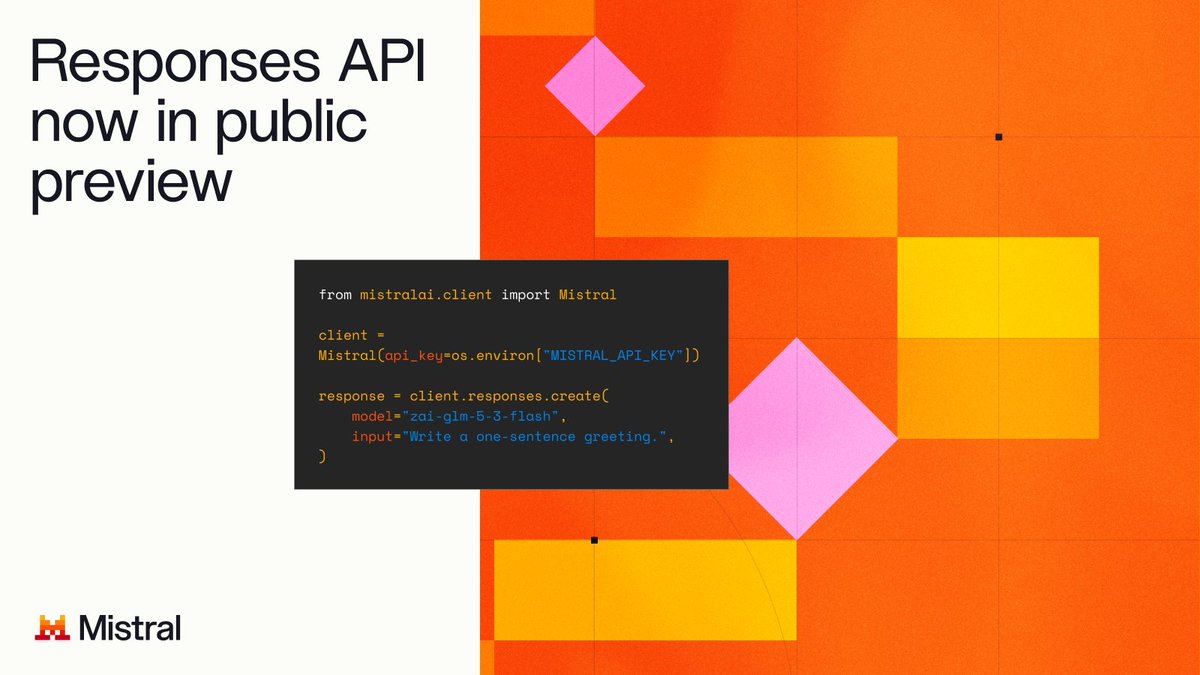
Mistral announced on October 28 that its Responses API, made for building agents on Mistral, is in public preview. According to Mistral, each response returns the model's answer, its reasoning and its tool calls as separate items, so an app can handle every step more easily than with Chat Completions. It works with all chat models hosted by Mistral, including Large 4. The documentation is on Mistral's Studio docs site.