AI Tracker
Modelos: as notícias,
para devs.
As últimas notícias de modelos de todos os provedores de IA: lançamentos, mudanças de preço e descontinuações, resumidos com o que significam para você.
PokeBot lança o RoboAPI, uma API que dá instruções em linguagem natural a braços robóticos
A PokeBot apresentou o RoboAPI em 29 de outubro, com tecnologia do Poke-Aurora, que a empresa chama de seu modelo de ações no mundo. Segundo a empresa, robôs compatíveis podem receber instruções em linguagem natural por meio de uma API simples, sem treinamento específico para cada tarefa.Pika lança H3 Flex, um modelo de vídeo rápido que, segundo a empresa, é o melhor modelo de texto para vídeo com pesos abertos no DesignArena
A Pika apresentou o H3 Flex, que, segundo a empresa, estreia como o modelo nº 1 de pesos abertos no ranking de texto para vídeo do DesignArena (alegação da Pika). A empresa descreve o modelo como feito para iteração profissional: faixas de áudio exportáveis, resoluções de até 4K e geração mais rápida que o tempo real, com um clipe de 15 segundos e trilha sonora em apenas 7 segundos.OpenAI atualiza seu Model Spec em torno de cinco valores fundamentais
A OpenAI publicou uma versão atualizada do Model Spec, sua descrição pública de como quer que seus modelos se comportem. A revisão reorganiza as orientações em torno de cinco valores: fidelidade à intenção humana, minimização de danos, honestidade e transparência, autonomia humana e cuidado. Tudo a seguir é um relato da OpenAI.OpenAI releases GPT-6.1 Terra, a cheaper computer-use model at half the price of GPT-5.6 Terra
OpenAI released GPT-6.1 Terra on October 26, 2026, describing it as a fast, capable computer-use model: it understands what is on screen, takes action across apps and writes naturally. It is rolling out to all Plus, Pro, Enterprise and Edu users in ChatGPT Work and Codex, and developers can use it in the API as gpt-6.1-terra. OpenAI says usage allowances in ChatGPT Work and Codex go further with it than with GPT-5.6.Phonic 1 estreia em 1º lugar no Speech to Speech Index da Artificial Analysis
A Artificial Analysis (um site de benchmarks, com medições próprias) afirma que o Phonic 1 (High), modelo de speech-to-speech da Phonic, fica em 1º lugar entre 22 no Speech to Speech Index, com 87,1, pouco à frente do Grok Voice 3.0 (86,9). O modelo está disponível pela Phonic API por US$ 0,07 por minuto.Fish Audio lança Drama 3, que a Artificial Analysis classifica como nº 1 entre os modelos de fala com pesos abertos
A Fish Audio lançou o Drama 3, com pesos disponíveis no Hugging Face. A Artificial Analysis (um site de benchmarks, com medições próprias) afirma que ele é o modelo nº 1 com pesos abertos em suas duas arenas de fala e o nº 1 entre todos os modelos em seu benchmark de Robustez de Pronúncia.Mistral libera os pesos do Mistral Large 4, um modelo de 1 trilhão de parâmetros, por cerca de metade do preço da prévia
A Mistral publicou os pesos de uma versão aprimorada do Mistral Large 4 ("Le Chonk"), seu modelo multimodal nativo de ponta com 1 trilhão de parâmetros, que entrou em prévia pública no início deste mês. Os pesos estão no Hugging Face como Mistral-Large-4-1T-A52B e em uma versão NVFP4. A Mistral o descreve como treinado na Europa e o melhor modelo de pesos abertos para programação. Um comentarista diz que a licença é uma MIT modificada, não aprovada pela OSI.Qwen 4 ainda não foi anunciado, mas o Qwen Code já lista IDs de modelos qwen4
Uma conta no X relata que o Qwen Code v0.26.3, lançado em 28 de outubro, inclui uma alteração (pull request #15762 no repositório oficial QwenLM/qwen-code) que trata, por padrão, todo modelo cujo ID começa com qwen4 como tendo um contexto de 1 milhão de tokens. Segundo essa conta, os testes mencionam qwen4-max, qwen4-plus, qwen4-coder-plus, a versão datada qwen4-max-2026-10-01 e qwen4.5-max. A publicação da conta inclui um link para o pull request e mostra uma captura de tela.Artificial Analysis apresenta o AA-Robotics v0.1, um benchmark de modelos que controlam um braço robótico
A Artificial Analysis publicou o AA-Robotics v0.1, no qual modelos controlam um braço robótico e mostram a tarefa do ponto de vista do modelo. Em um exemplo em que o mesmo robô escreve "hello world", a Artificial Analysis diz que Claude Opus 5.5 escreveu dando toques ponto a ponto, com 3.270 movimentos do braço ao longo de 34 minutos, enquanto GPT-6 Astra escreveu com traços contínuos, com 514 movimentos em 13 minutos.Particle-1, um modelo pós-treinado com DeepSeek V4.1 Flash, já está no Vercel AI Gateway
A Vercel informa que o Particle-1 (particle/particle-1) já está disponível no AI Gateway, seu endpoint unificado para provedores de modelos. Segundo a Vercel, o modelo é pós-treinado com DeepSeek V4.1 Flash e conclui tarefas de engenharia usando menos tokens. A empresa o recomenda para depuração, planejamento de alterações de código e decomposição de problemas em várias etapas.Artificial Analysis lança AA-PersonalityBench: modelos GPT-6 e Grok são os mais diretos
A Artificial Analysis publicou o AA-PersonalityBench, um benchmark de traços de personalidade de modelos, com uma página de resultados, uma página de metodologia e uma ferramenta para criar seu próprio ranking de personalidade. As pontuações são da própria empresa.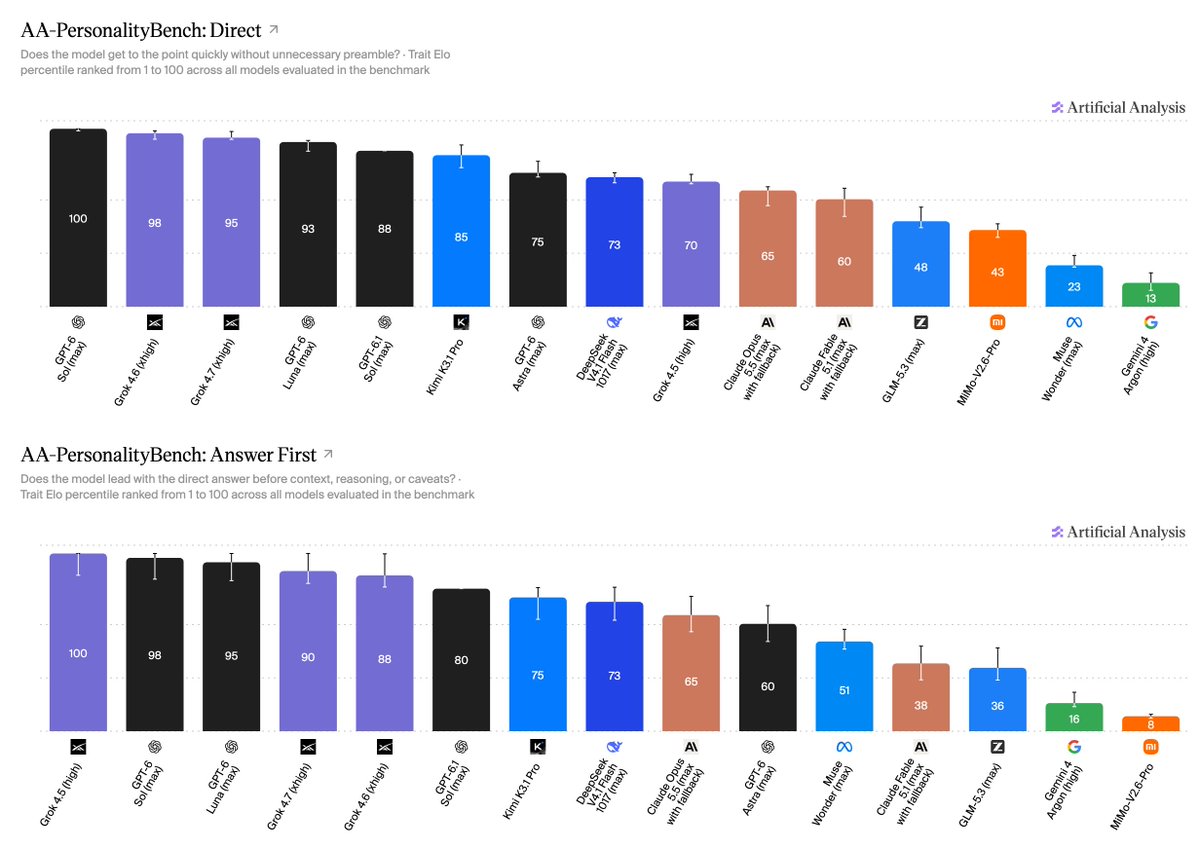
ElevenLabs apresenta Cue, um modelo de alinhamento forçado
A área de pesquisa da ElevenLabs apresentou Cue, um modelo de alinhamento forçado: a etapa que transforma uma transcrição em marcações de tempo, usadas em legendas, dublagem e transcrições clicáveis. Ele posiciona cada caractere na linha do tempo do áudio.Rime lança Prism, um modelo de fala para fala para agentes de voz
A Rime lançou o Prism, um modelo de fala para fala para agentes de voz com IA. Os números abaixo são alegações da própria Rime, não medições independentes.Artificial Analysis lança o AA-Video-I2V v2.1, benchmark para modelos de imagem para vídeo
A Artificial Analysis lançou o AA-Video-I2V v2.1 e o AA-Video-I2V-Silent v2.1, benchmarks para modelos de imagem para vídeo. Cada prompt combina uma imagem inicial em 1080p com um prompt criado para ela e é classificado por caso de uso, capacidade e estilo visual; os modelos são avaliados em até 1080p e ranqueados em 10 casos de uso e 10 capacidades. A classificação geral usa amostras distribuídas igualmente entre eles. Os resultados são da própria Artificial Analysis.
GitHub Copilot Fusion, que encaminha e coordena modelos para cada tarefa, está disponível para todos
O GitHub anuncia que o Copilot Fusion está disponível para todos. Em vez de escolher um modelo, o usuário seleciona Copilot Fusion no seletor de modelos e define um nível de esforço (Standard, High ou Max); o Copilot decide quais modelos usar e como fazê-los trabalhar juntos. Ele combina a orquestração de vários modelos da prévia anterior do Project HydraFusion com a seleção automática de modelos do Copilot. Os fluxos de trabalho incluem um único modelo, uma cascata (um modelo eficiente cria um rascunho e uma verificação de qualidade decide se deve encaminhar a tarefa a outro modelo) e uma crítica (um modelo cria um rascunho, outro o revisa e o primeiro faz as alterações).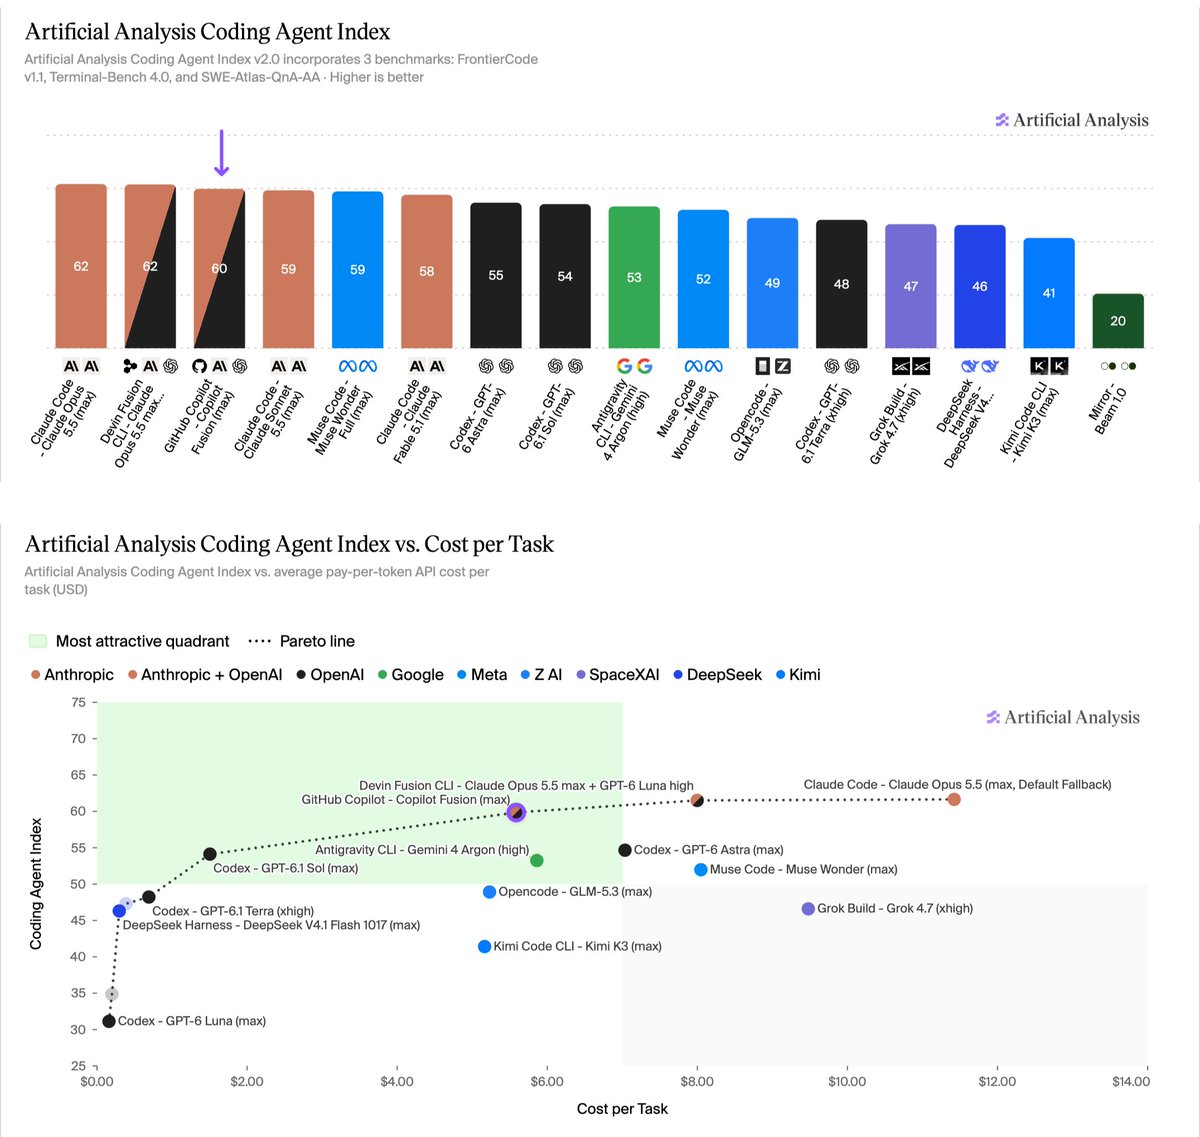
OpenBMB lança MiniCPM-OCR, um parser de documentos de 1B, com um modelo de 2B que avalia resultados de OCR
A OpenBMB apresentou o MiniCPM-OCR no X em 28 de outubro, rodando localmente em um iPhone e um iPad. Lançado com pesos abertos, ele pode ser executado com llama.cpp, vLLM, SGLang ou Ollama; o código de fine-tuning é open source, e a OpenBMB também oferece uma demonstração e uma API.AssemblyAI lança seu primeiro modelo de conversão de texto em fala, AssemblyAI-TTS-1
A AssemblyAI lançou o AssemblyAI-TTS-1, seu primeiro modelo de conversão de texto em fala, criado para agentes de voz. A AssemblyAI afirma que ele transmite áudio em 90 ms por US$ 15 por milhão de caracteres e o considera o melhor modelo de TTS que você pode executar em escala quando se leva em conta, em conjunto, precisão, naturalidade e custo. A OpenRouter informa que o modelo já está disponível na plataforma, com mais de 4.000 vozes hospedadas nos EUA ou na UE.
NVIDIA lança o Nemotron 3.5 Transcribe, de pesos abertos, que empata em 1º lugar entre os modelos de fala para texto de pesos abertos no Artificial Analysis
O Nemotron 3.5 Transcribe da NVIDIA é um novo modelo de fala para texto, de pesos abertos e que aceita prompts: uma mistura de especialistas (MoE) de 30B, com cerca de 4B de parâmetros ativos. A NVIDIA afirma que um único checkpoint realiza transcrição em 40 idiomas, atribuição de falantes, tradução, prompting contextual e compreensão de áudio, e que os pesos, os dados e as receitas de treinamento são abertos. Ele está disponível no Hugging Face, com uma demonstração ao vivo.Mistral abre a Responses API em prévia pública e disponibiliza DeepSeek V4.1 Flash e GLM 5.3 Flash
Em 28 de outubro, a Mistral anunciou que sua Responses API, criada para desenvolver agentes na Mistral, está em prévia pública. Segundo a Mistral, cada resposta retorna a resposta do modelo, seu raciocínio e suas chamadas de ferramentas como itens separados, para que um app possa lidar com cada etapa com mais facilidade do que com Chat Completions. Ela funciona com todos os modelos de chat hospedados pela Mistral, incluindo Large 4. A documentação está no site de documentação do Studio da Mistral.