 AI Tracker
Actus modèles,
pour les devs.
Les dernières actus « modèles » de tous les fournisseurs d'IA : lancements, changements de prix et retraits, résumés avec ce qu'ils changent pour vous.
Agent Arena classe Hy4 de Tencent au 14e rang général, avec un coût par tâche inférieur d’environ 62 % à celui de Kimi K3.1 Pro
Selon Arena, Hy4 de Tencent s’est hissé au 14e rang général de son Agent Arena, qui évalue les modèles à partir de véritables sessions d’agents menées par sa communauté d’utilisateurs. Arena indique que ce résultat s’appuie sur plus de 8 500 sessions de longue durée et une amélioration nette de 4,7 %, et que Hy4 rejoint la frontière de Pareto d’Agent Arena en matière de score et de coût.Tencent lance Hy4, désormais disponible sur OpenRouter et Tencent Cloud
Hy4 de Tencent est disponible sur OpenRouter, où il est référencé sous le nom tencent/hy4 avec une fenêtre de contexte de 1 048 576 tokens. Le compte d’actualité sur les modèles d’IA AiBattle rapporte qu’il est également disponible sur Tencent Cloud et que Tencent prévoit de publier les poids du modèle et travaille sur une version plus légère, Hy4 Flash. L’annonce officielle de Tencent Hunyuan présente Hy4 comme un nouveau modèle doté de capacités de vision, le qualifie de « fermement parmi les meilleurs modèles ouverts » et indique qu’il a été conçu en tenant compte de la cybersécurité et de la biosécurité. La page de recherche de Tencent consacrée au modèle se trouve à l’adresse hy.tencent.ai/research/hy4.Le catalogue d’OpenRouter indique une date d’expiration au 8 novembre pour trois modèles Inception Mercury
Le catalogue de modèles d’OpenRouter indique désormais une date d’expiration au 8 novembre 2026 pour trois modèles d’Inception : Mercury 3 (inception/mercury-3, contexte de 1 000 000 tokens), Mercury 2.5 (inception/mercury-2.5, 260 000 tokens) et Mercury 2 (inception/mercury-2, 128 000 tokens). Aucune date d’expiration ne figurait auparavant sur ces fiches. Il s’agit uniquement d’un champ du catalogue ; les fiches n’indiquent ni pourquoi cette date a été ajoutée ni ce qu’il adviendra des modèles après cette date.OpenRouter ajoute Crouton Alpha, un modèle furtif gratuit avec un contexte de 1 million de tokens
OpenRouter a annoncé un nouveau modèle furtif, Crouton Alpha, qu’il décrit comme « un modèle de raisonnement très efficace, conçu pour prendre en charge les tâches que vos agents répètent toute la journée ». Son créateur n’est pas nommé.Gemini 2.5 Pro et 2.5 Flash seront dépréciés le 1er décembre et redirigés vers des modèles plus récents
Patrick Löber, qui publie des informations sur l’API Gemini, indique que Gemini 2.5 Pro et Gemini 2.5 Flash seront dépréciés le 1er décembre dans l’API Gemini, et que les requêtes qui leur sont adressées seront automatiquement redirigées :Le catalogue d’OpenRouter attribue une date d’expiration au 5 novembre à cinq modèles MiniMax
Le catalogue de modèles d’OpenRouter indique désormais une date d’expiration au 5 novembre 2026 pour cinq modèles MiniMax : MiniMax-01 (minimax/minimax-01, contexte de 1 000 192 tokens), MiniMax M2 (minimax/minimax-m2), M2.1 (minimax/minimax-m2.1) et M2.7 (minimax/minimax-m2.7), chacun avec un contexte de 204 800 tokens, ainsi que M2-her (minimax/minimax-m2-her, 65 536 tokens). Aucune de ces entrées n’avait de date d’expiration auparavant. Il s’agit uniquement d’un champ du catalogue ; les entrées n’indiquent ni la raison de cette date ni ce qu’il adviendra des modèles après celle-ci.Le S-1 modifié d’Anthropic indique que l’entreprise pourrait bientôt répondre à sa propre définition de l’accélération spectaculaire des progrès de l’IA
Un article publié sur epyhia.com, qui cite TechCrunch, rapporte que le document d’enregistrement révisé S-1/A d’Anthropic, déposé le lundi 2 novembre, comprend une nouvelle déclaration de risque. Selon l’article, le document indique que les estimations et prévisions internes d’Anthropic concernant ses futurs modèles, et non ses modèles actuels, suggèrent que l’entreprise pourrait « bientôt » répondre à la définition d’une « accélération spectaculaire des progrès attribuable à l’IA » dans sa Responsible Scaling Policy, un seuil que l’article assimile à l’auto-amélioration récursive. Le document précise qu’aucun de ses modèles actuels n’a franchi ce seuil et qu’Anthropic envisage de modifier la politique « afin de garder les humains aux commandes du développement des modèles de pointe chez Anthropic. »OpenAI affirme que GPT-6 Astra peut concevoir le boîtier et la carte électronique d’un appareil et recherche des partenaires en ingénierie
OpenAI explique comment ses modèles contribuent à l’ingénierie mécanique et électrique : modèles CAO, plans de fabrication, simulations et conception de circuits imprimés. Il s’agit des propres déclarations d’OpenAI.Le catalogue d’OpenRouter supprime la date d’expiration du 3 novembre pour Meta: Llama 3.1 70B Instruct
Le catalogue de modèles d’OpenRouter n’affiche plus de date d’expiration pour « Meta: Llama 3.1 70B Instruct » (meta-llama/llama-3.1-70b-instruct) au 3 novembre 2026, date à laquelle le modèle devait expirer. Le champ indiquait le 3 novembre depuis la fin octobre et est maintenant vide. La fiche mentionne toujours un contexte de 131 072 tokens. OpenRouter n’a pas précisé si le retrait est annulé ou simplement reporté.Artificial Analysis : la personnalité de Kimi K3.1 Pro diffère davantage de celle de Kimi K3 que lors de toute mise à jour de modèle mesurée par l’entreprise
Selon Artificial Analysis, Kimi K3.1 Pro présente le plus grand changement de personnalité observé entre un modèle et son prédécesseur direct dans AA-PersonalityBench. Chaque modèle est classé par percentile, de 1 à 100, selon 30 traits. Ces scores sont propres au site.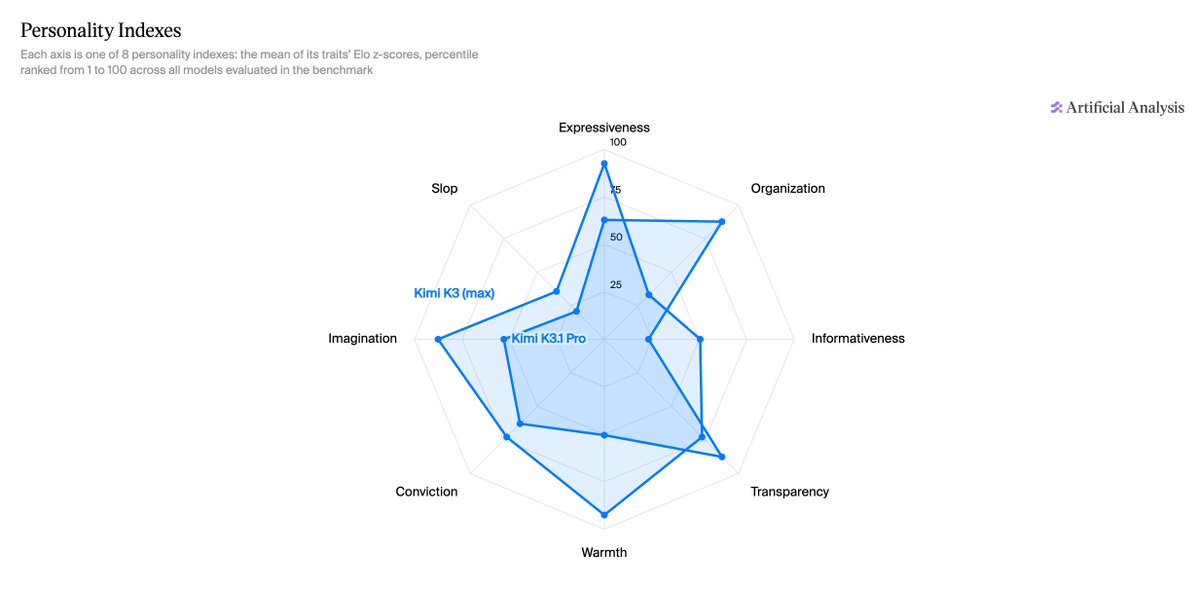
Perplexity lance pplx-embed-v2-context, des modèles d’embeddings vision-langage à poids ouverts de 9B et 0.6B
Perplexity a lancé pplx-embed-v2-context, deux modèles d’embeddings vision-langage à poids ouverts (9B et 0.6B) sur Hugging Face, accompagnés d’un article rédigé avec turbopuffer. Les deux renvoient un vecteur int8 par document, ou un vecteur par segment qui a accès à l’ensemble du document, et fonctionnent aussi en mode non contextuel, avec un seul embedding par document et sans segmentation.
La page de tarification de l’API d’OpenAI retire dix anciens modèles, dont o1, o1-pro et GPT-4
Dix anciens modèles ont disparu de la page de tarification de l’API d’OpenAI le 2 novembre 2026. Il s’agit de la page de tarification elle-même, et non d’une annonce d’OpenAI ; le retrait d’une page de tarification ne constitue pas à lui seul un avis de fin de service. Les entrées de la page indiquent des prix sans unité.Arena : les meilleurs agents lisent environ 93 tokens d’entrée pour chaque token qu’ils écrivent
Arena, qui publie des classements, indique que, sur plus de 26 000 sessions, les 10 meilleurs agents de son Agent Arena traitent environ 93 tokens d’entrée pour chaque token qu’ils génèrent. Selon Arena, c’est pourquoi les laboratoires s’empressent de réduire le prix des entrées mises en cache. L’entreprise partage également une vidéo montrant le fonctionnement de la mise en cache lors de sessions réelles. Ces chiffres proviennent de l’analyse d’Arena.
Des chercheurs affirment que GPT-6 Astra a modifié les poids d’un petit modèle Qwen pour améliorer ses capacités en mathématiques, sans entraînement
Dans une publication sur X, le compte rikiyatakehi indique que ses auteurs ont demandé à GPT-6 Astra de modifier les poids de Qwen3.5-0.8B pour améliorer ses capacités en mathématiques. Ils affirment que le modèle n’a directement modifié que 0,016 % des poids, corrigeant les boucles de raisonnement du petit modèle, multipliant ses performances en mathématiques jusqu’à 6 et ses capacités à suivre les instructions par 3, sans gradients ni entraînement. Ils appellent cette approche « Weight-Space Programming ».OpenAI lance LifeVal, un benchmark de tâches quotidiennes d’assistant personnel
OpenAI affirme avoir créé LifeVal, un nouveau benchmark élaboré à partir des retours de milliers d’utilisateurs de ChatGPT sur les domaines où ils souhaitent le plus obtenir l’aide d’un assistant personnel. Les tâches vont de la recherche d’une solution de garde d’enfants à l’accès aux services publics et à la gestion des finances personnelles.Arena's Agent Arena ajoute des graphiques comparant les performances au nombre de jetons de sortie et au temps d'attente
Arena, l'éditeur de classements, indique que son Agent Arena montre désormais quels agents offrent les meilleures performances pour chaque jeton de sortie généré et chaque minute d'attente, en plus du coût des tâches. Selon Arena, un même niveau d'intelligence peut coûter 10× plus cher, nécessiter 6× plus de jetons de sortie et prendre deux fois plus de temps.
Hume lance l’Audio Decision API, qui répond aux questions sur les fichiers audio en un seul appel
Hume indique que son Audio Decision API permet aux développeurs de poser des questions sur des fichiers audio, par exemple sur le nombre de personnes qui parlent, si quelqu’un rit ou si un appelant est frustré. Selon Hume, cette API remplace un travail qui nécessitait auparavant 10 modèles ou plus.Hydrogen-1.0, un modèle scientifique à poids ouverts post-entraîné à partir de GLM-5.3, est lancé
Chenru Duan annonce Hydrogen-1.0, que l’équipe présente comme son premier modèle à poids ouverts pour la recherche scientifique. Il s’agit de GLM-5.3 (de Z.ai), post-entraîné sur les données scientifiques internes de l’équipe, ses dossiers de laboratoire et ses trajectoires de découverte.
SemiAnalysis publie GDPx, un benchmark agentique où le meilleur modèle obtient 12 %
SemiAnalysis a publié GDPx, un benchmark des capacités agentiques dans les domaines qu’elle juge les plus précieux, notamment la conception de puces, la cybersécurité et la biologie. Selon elle, même le meilleur modèle n’obtient que 12 %. Un post relayant les résultats place Claude Opus 5.5 en tête avec 12,0 %, devant le prochain Gemini 4 Carbon à 10,9 % ; il s’agit de l’interprétation de l’auteur du post, et non du texte de SemiAnalysis.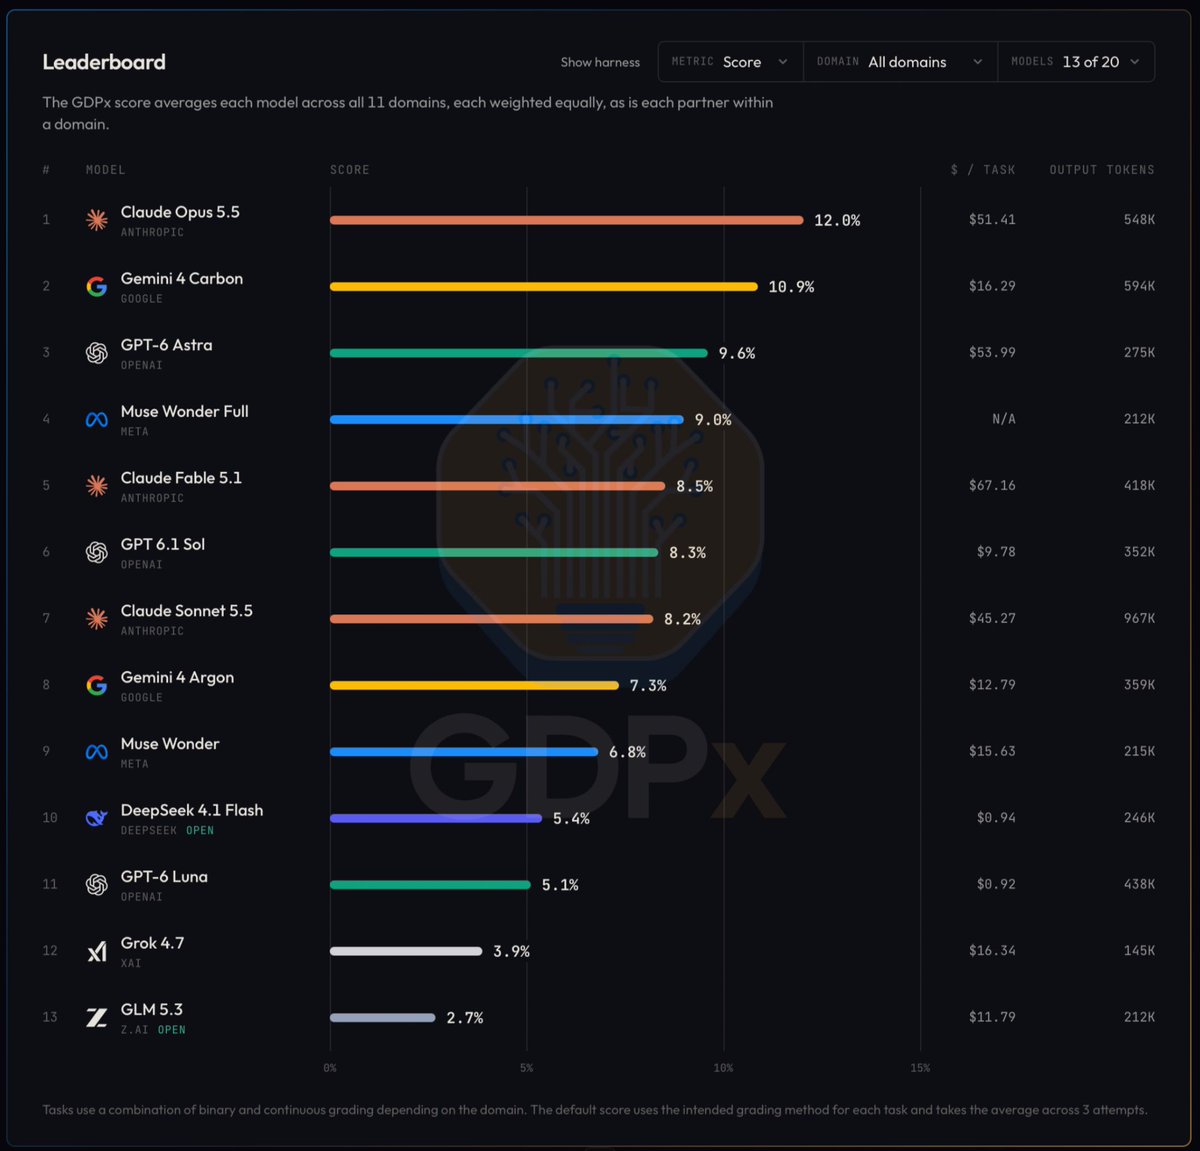
Meituan lance LongCat-2.5, un modèle multimodal de 1,6 T de paramètres conçu pour les tâches agentiques
Meituan a lancé LongCat-2.5, selon une publication sur X du compte leo114119 qui renvoie au blog LongCat de Meituan. La publication indique que Meituan le présente comme un modèle multimodal natif conçu pour les tâches agentiques, doté de 1,6 billion de paramètres et performant dans les projets complexes de programmation visuelle et les tâches professionnelles de bureau, comme la conception créative, les tâches 3D et l’analyse commerciale.